

换了一套数据库,先不急着钻研复杂语法。日常开发中最常遇到的,仍然是那些基础条件:=、、like、in、between、is null、order by、limit、group by。这些语法看似简单,但在迁移 SQL 或排查接口数据时,最容易因为“应该差不多”而疏忽,最终掉进坑里。 本文使用一张小型
SQL查询优化:WHERE条件别凭习惯写,先跑一遍
作者:技术拾光
时间:2026-06-27
浏览:408
文章目录
换了一套数据库,先不急着钻研复杂语法。日常开发中最常遇到的,仍然是那些基础条件:=、<>、like、in、between、is null、order by、limit、group by。这些语法看似简单,但在迁移 SQL 或排查接口数据时,最容易因为“应该差不多”而疏忽,最终掉进坑里。
本文使用一张小型测试表,集中运行常见查询条件。环境为已初始化的 app_db,表位于 app_schema 下。当前实例初始化时启用了 --enable-ci,因此大小写相关的结果仅适用于当前环境,不能直接推广到所有安装模式。这一前提至关重要,后续许多结论都与此绑定。
准备一批够用的测试数据
测试表名为 app_schema.t_filter_demo,字段设计简洁:name 存储名称,category 存储分类,status 存储状态,score 和 price 用于范围查询、排序和聚合,remark 专门用于 NULL 判断。
数据共 12 行,涵盖多种分类:mysql、Kingbase、sql、oracle、pgsql;状态包括 online、offline、draft;name 中特意包含了 MySQL-basic、mysql-limit、MYSQL-LIKE 等大小写不同的值。score 有一行为 NULL,remark 有 4 行为 NULL。后续每个查询都基于这批数据展开。
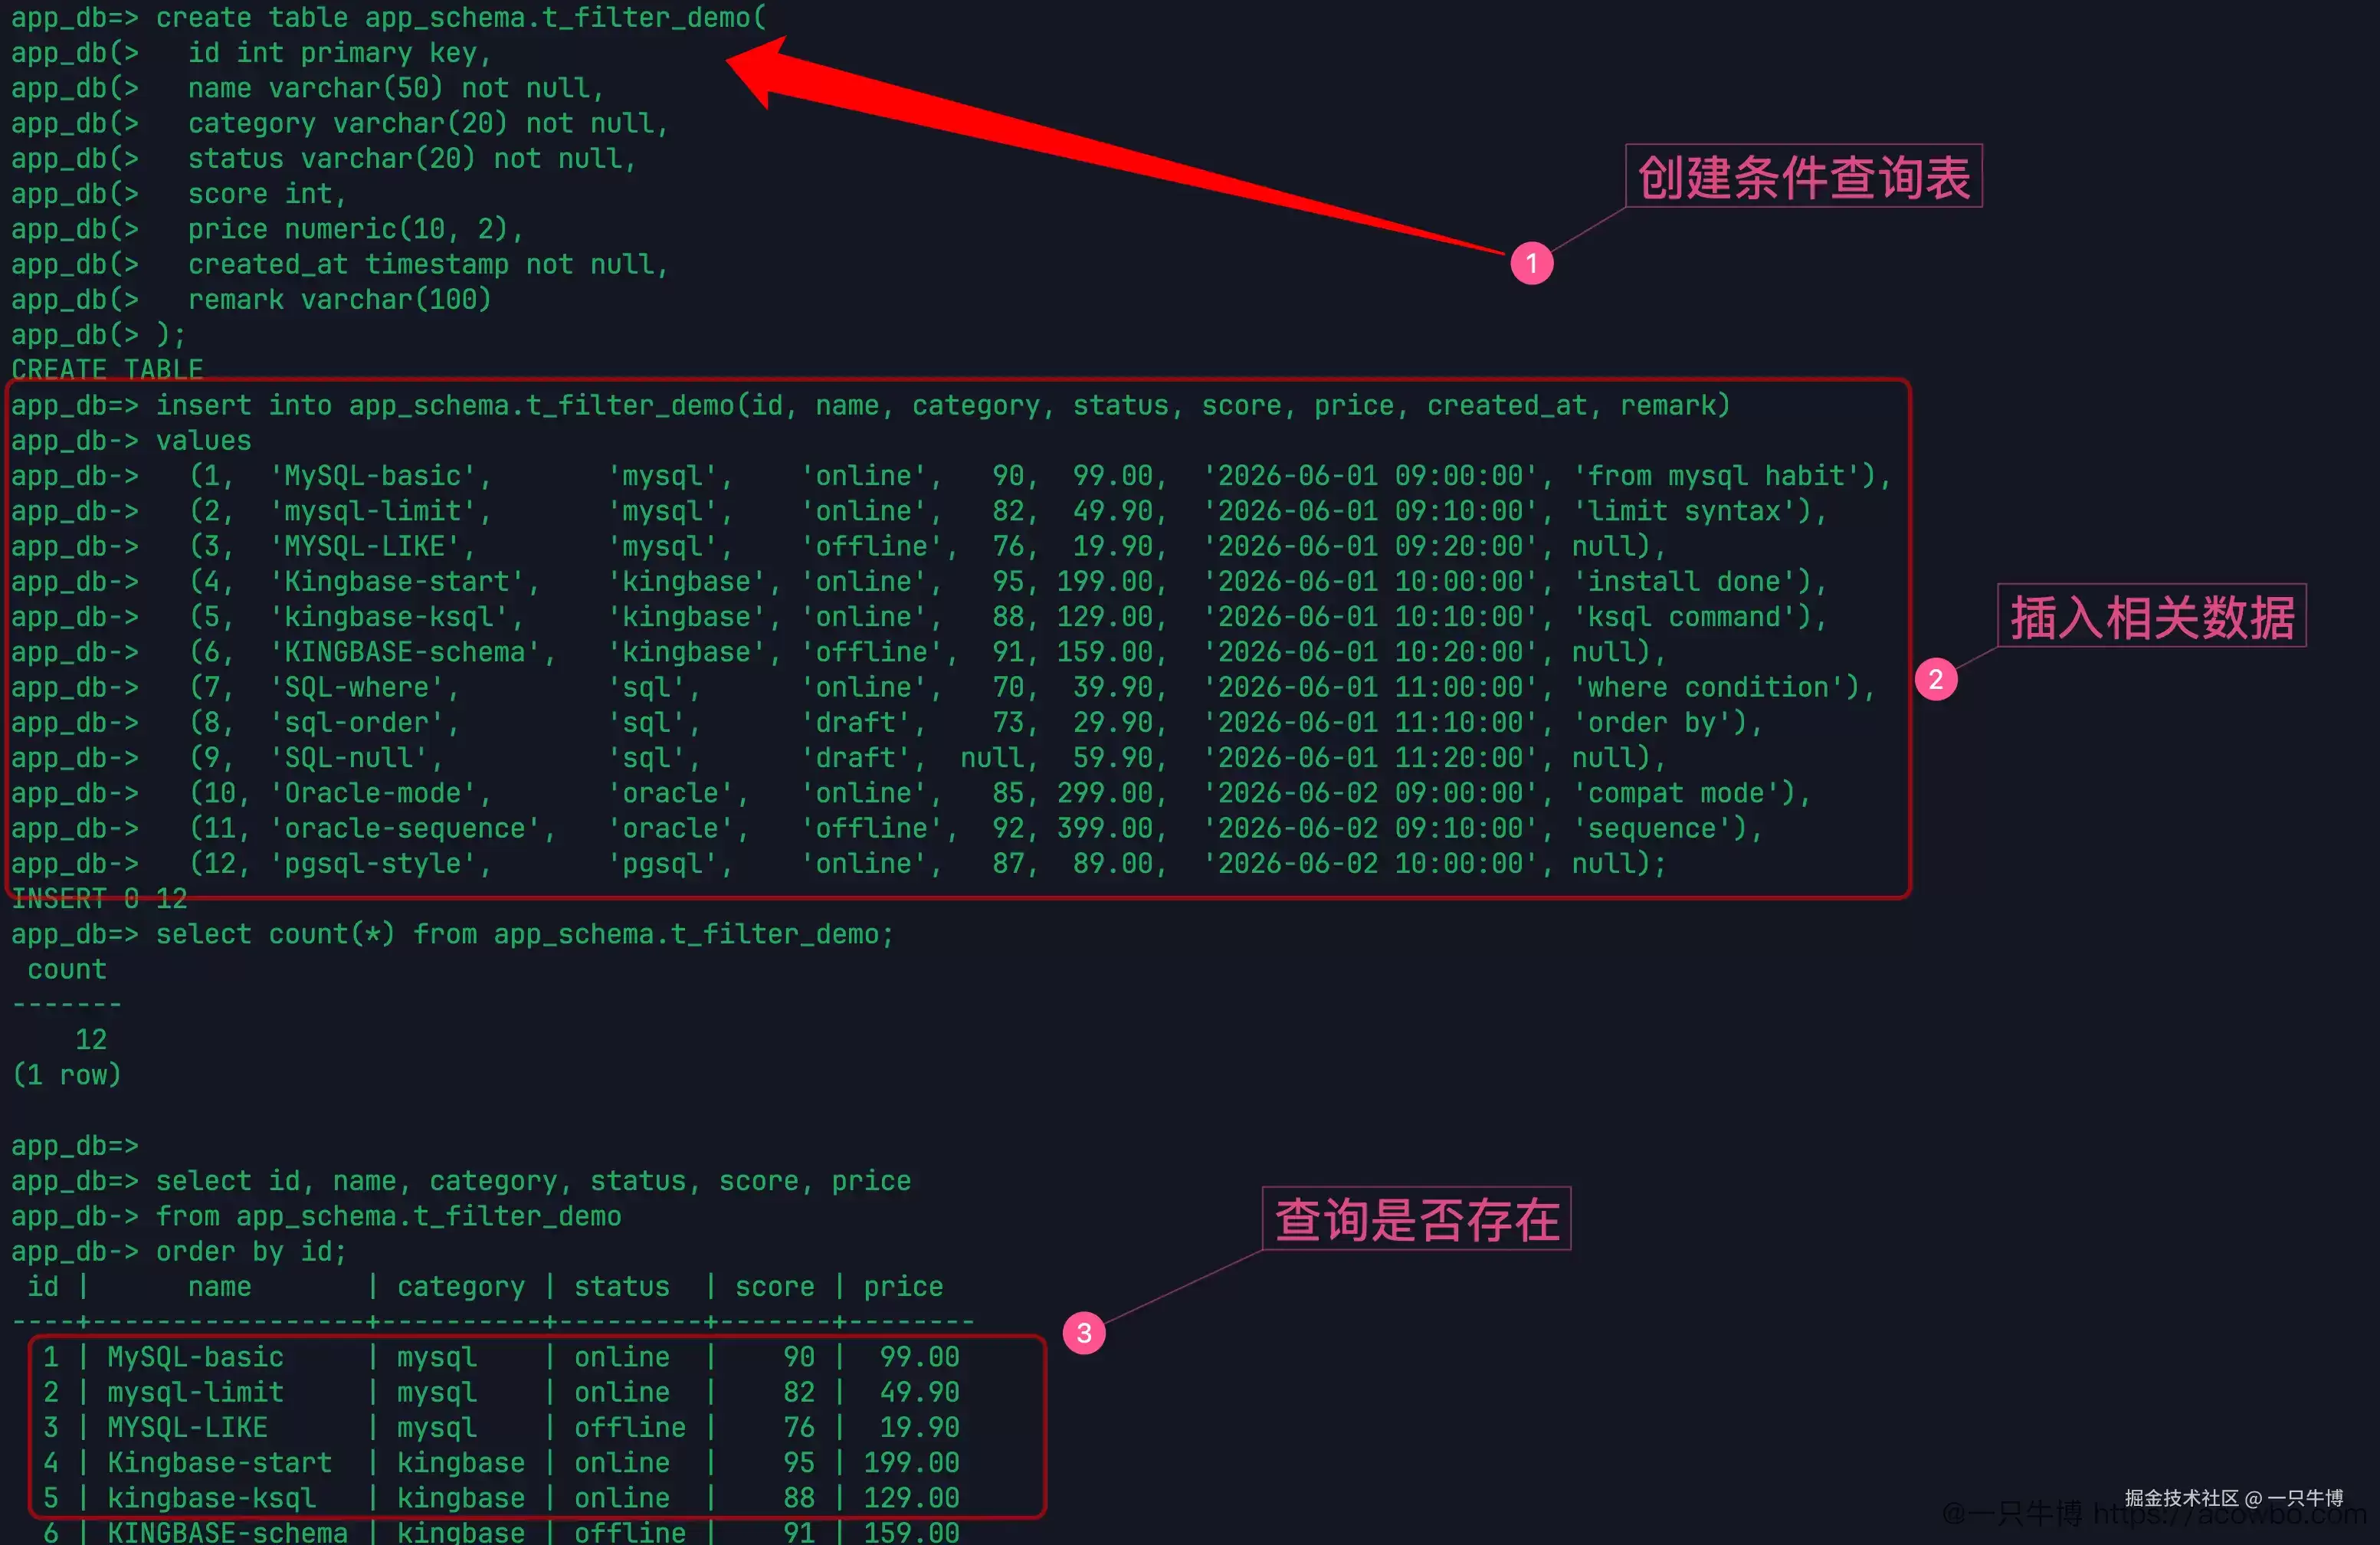
该表并非业务模型,而是专为测试查询条件而设计。例如,category 适用于 in 和 group by,status 适用于不等值和分组统计,score 适用于 between、排序和聚合函数,remark 适用于 NULL 判断。
终端提示符为 app_db=>,表明当前连接库为 app_db,当前用户并非管理员。这类细节平时容易忽略,但在编写查询实验时非常有用——可以确认没有误连到安装时的 test 库,也没有继续使用 system 执行所有操作。
等值和不等值:基础但关键
最普通的等值查询没有悬念:
 select id, name, category, status, score
from app_schema.t_filter_demo
where category = 'mysql'
order by id;
返回 1、2、3 三行数据,均为 mysql 分类。先跑通最基础的 where category = 'mysql',为后续叠加更多条件打下基础。
不等值查询使用了两种写法:
where status <> 'online'
以及:
where status != 'online'
两次返回结果完全一致,均为 3、6、8、9、11 这 5 行数据,即 offline 和 draft 状态的数据。在当前环境下,<> 和 != 均可正常使用。编写迁移脚本时,如果原 MySQL SQL 中使用了 !=,至少在这个场景下不会直接报错。
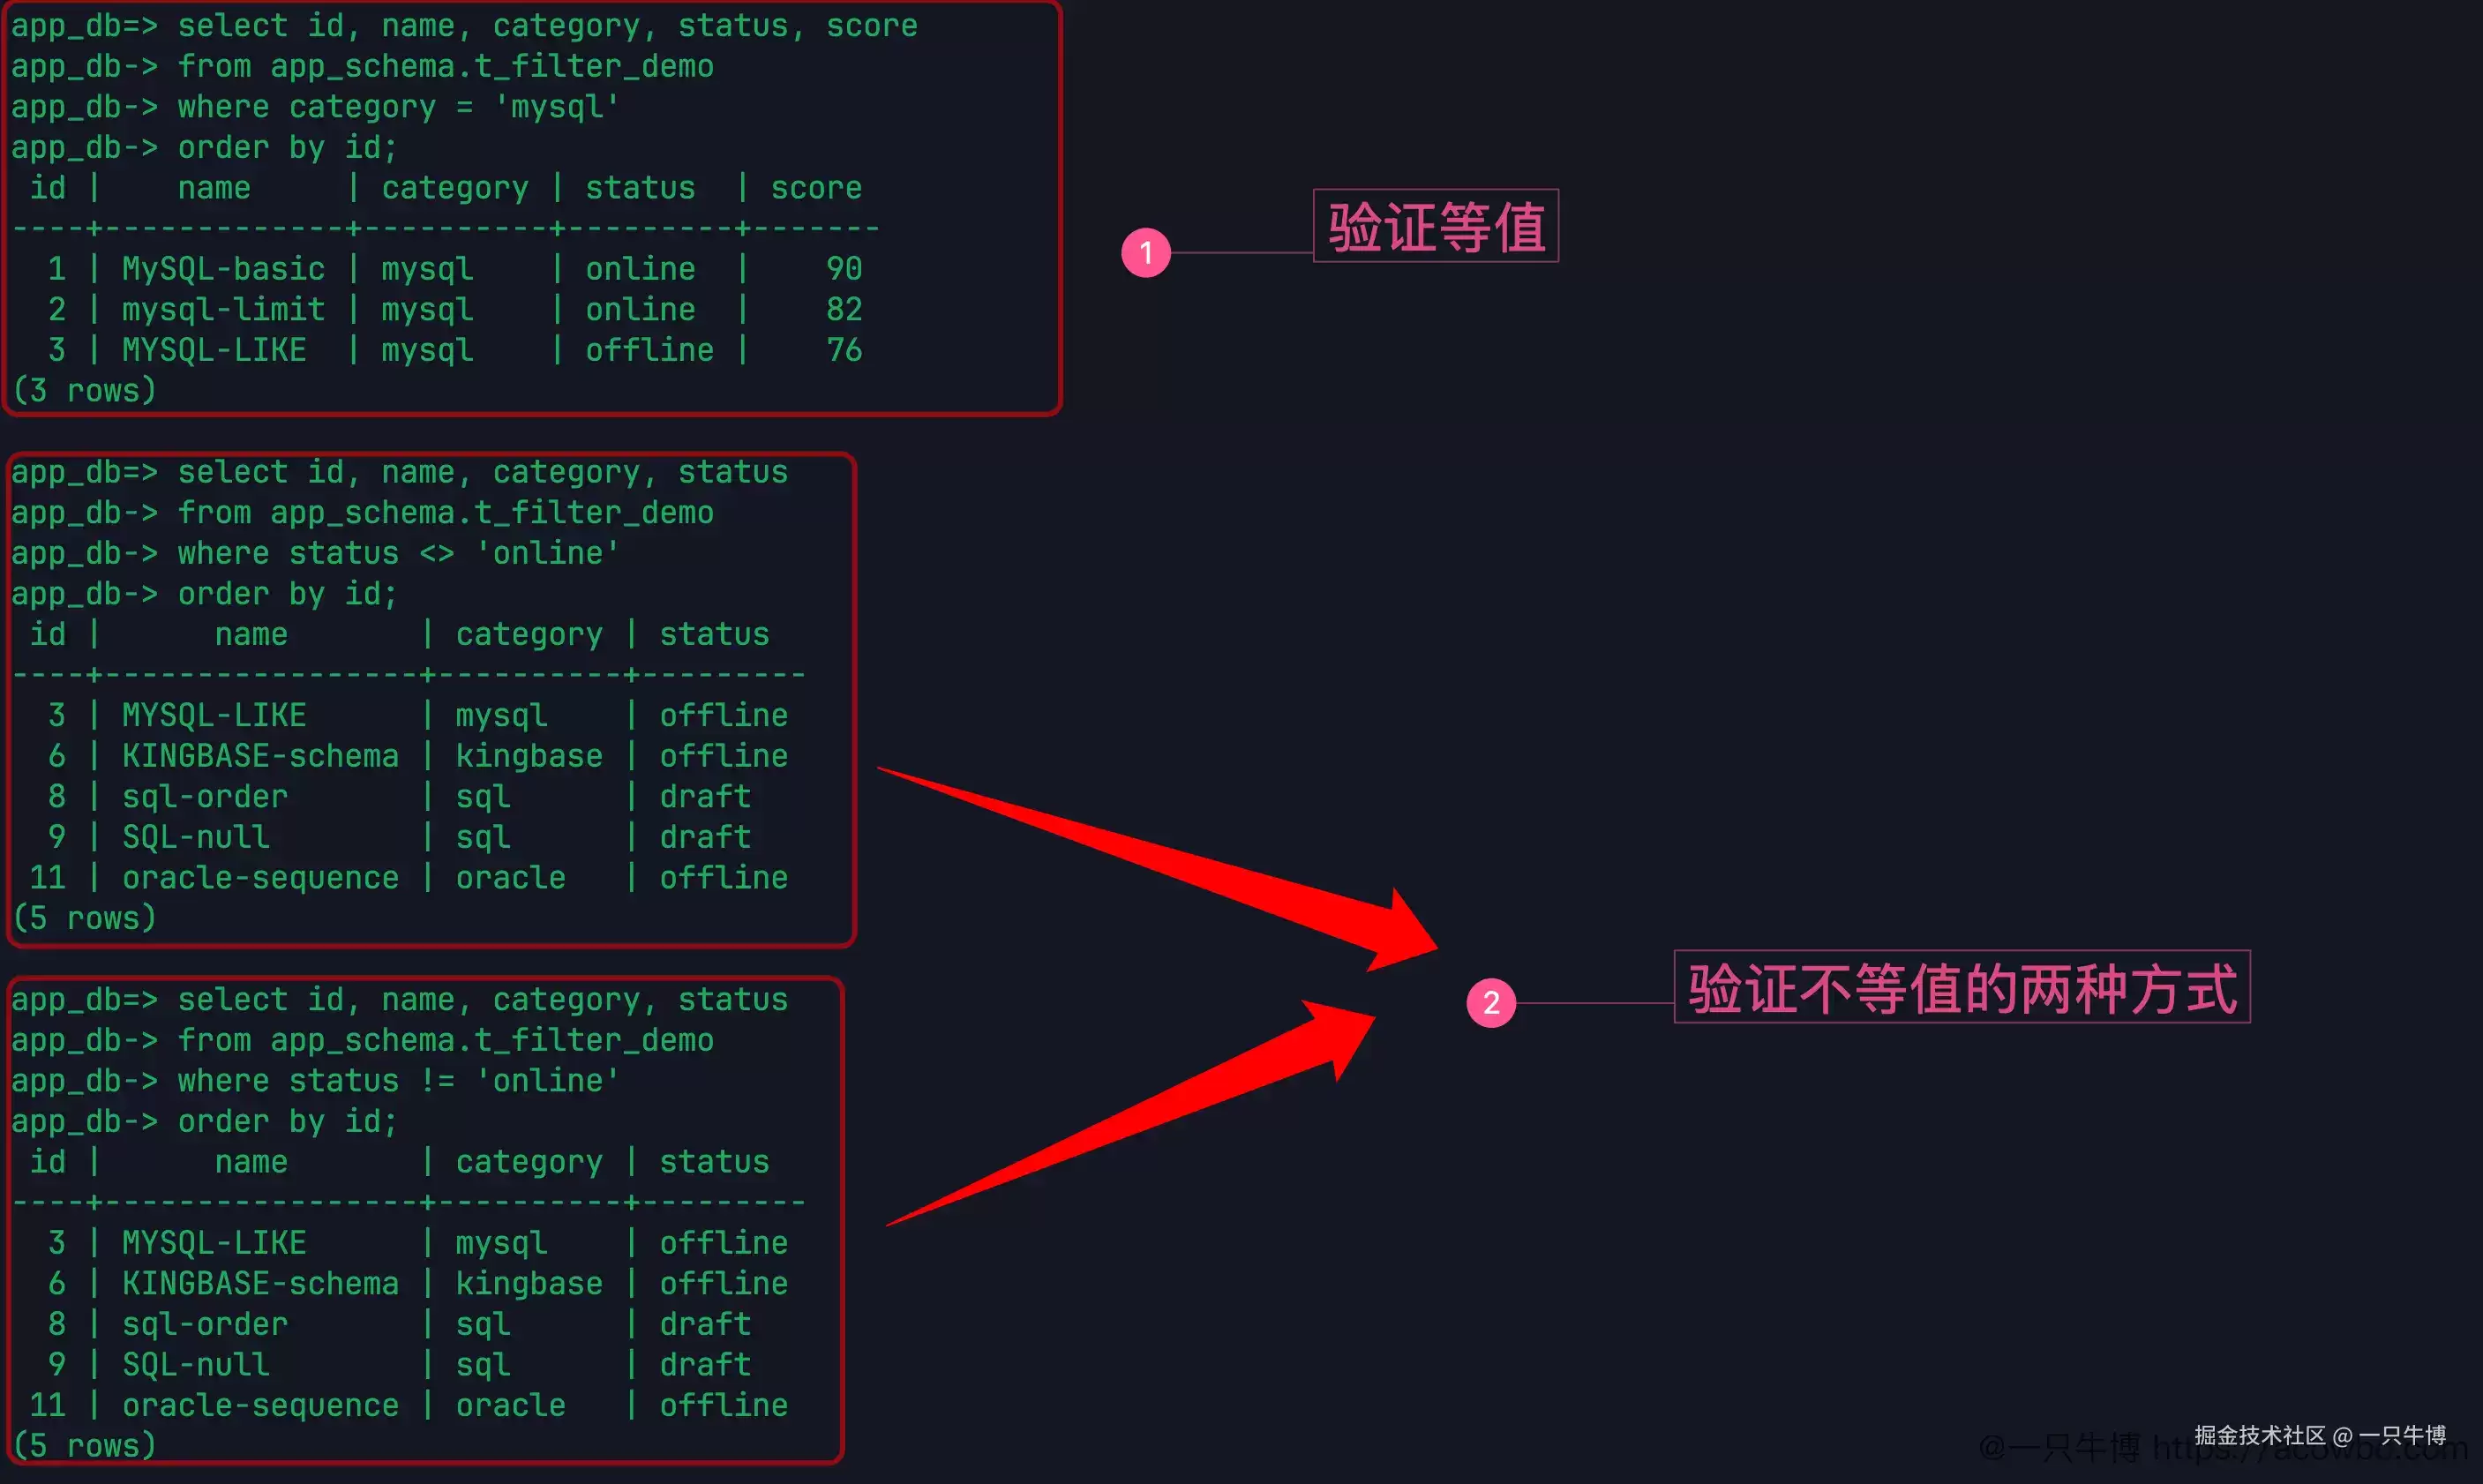
不过从长期来看,<> 更接近标准 SQL 写法;!= 则更多源自 MySQL 使用习惯。能否使用是一回事,团队内部如何统一又是另一回事。
这里还顺手验证了一点:status <> 'online' 返回的是所有非 online 的明确值,不会将 NULL 混入结果。当前测试表的 status 字段为 not null,因此结果清晰可读。如果业务表中状态字段允许 NULL,不等值条件就需要重新审视,不能想当然地将 NULL 视为“不是 online”。
AND 和 OR:括号不能省
先看组合条件中的 and:
 select id, name, category, status, score
from app_schema.t_filter_demo
where category = 'Kingbase'
  and status = 'online'
order by id;
返回 4、5 两行。表中 category 存储的是 kingbase,查询中写的是 Kingbase,当前环境仍然匹配成功。这一现象与前面提到的 --enable-ci 有关,大小写不敏感并非随意假设,而是本次查询结果的实际体现。
再将 or 加入组合条件:
 where (category = 'mysql' or category = 'Kingbase')
  and status = 'online'
返回 1、2、4、5 四行数据。这里的括号必不可少。没有括号时,阅读 SQL 的人需要在脑中重新计算 and 和 or 的优先级;有括号时,条件分组直接呈现在语句中。
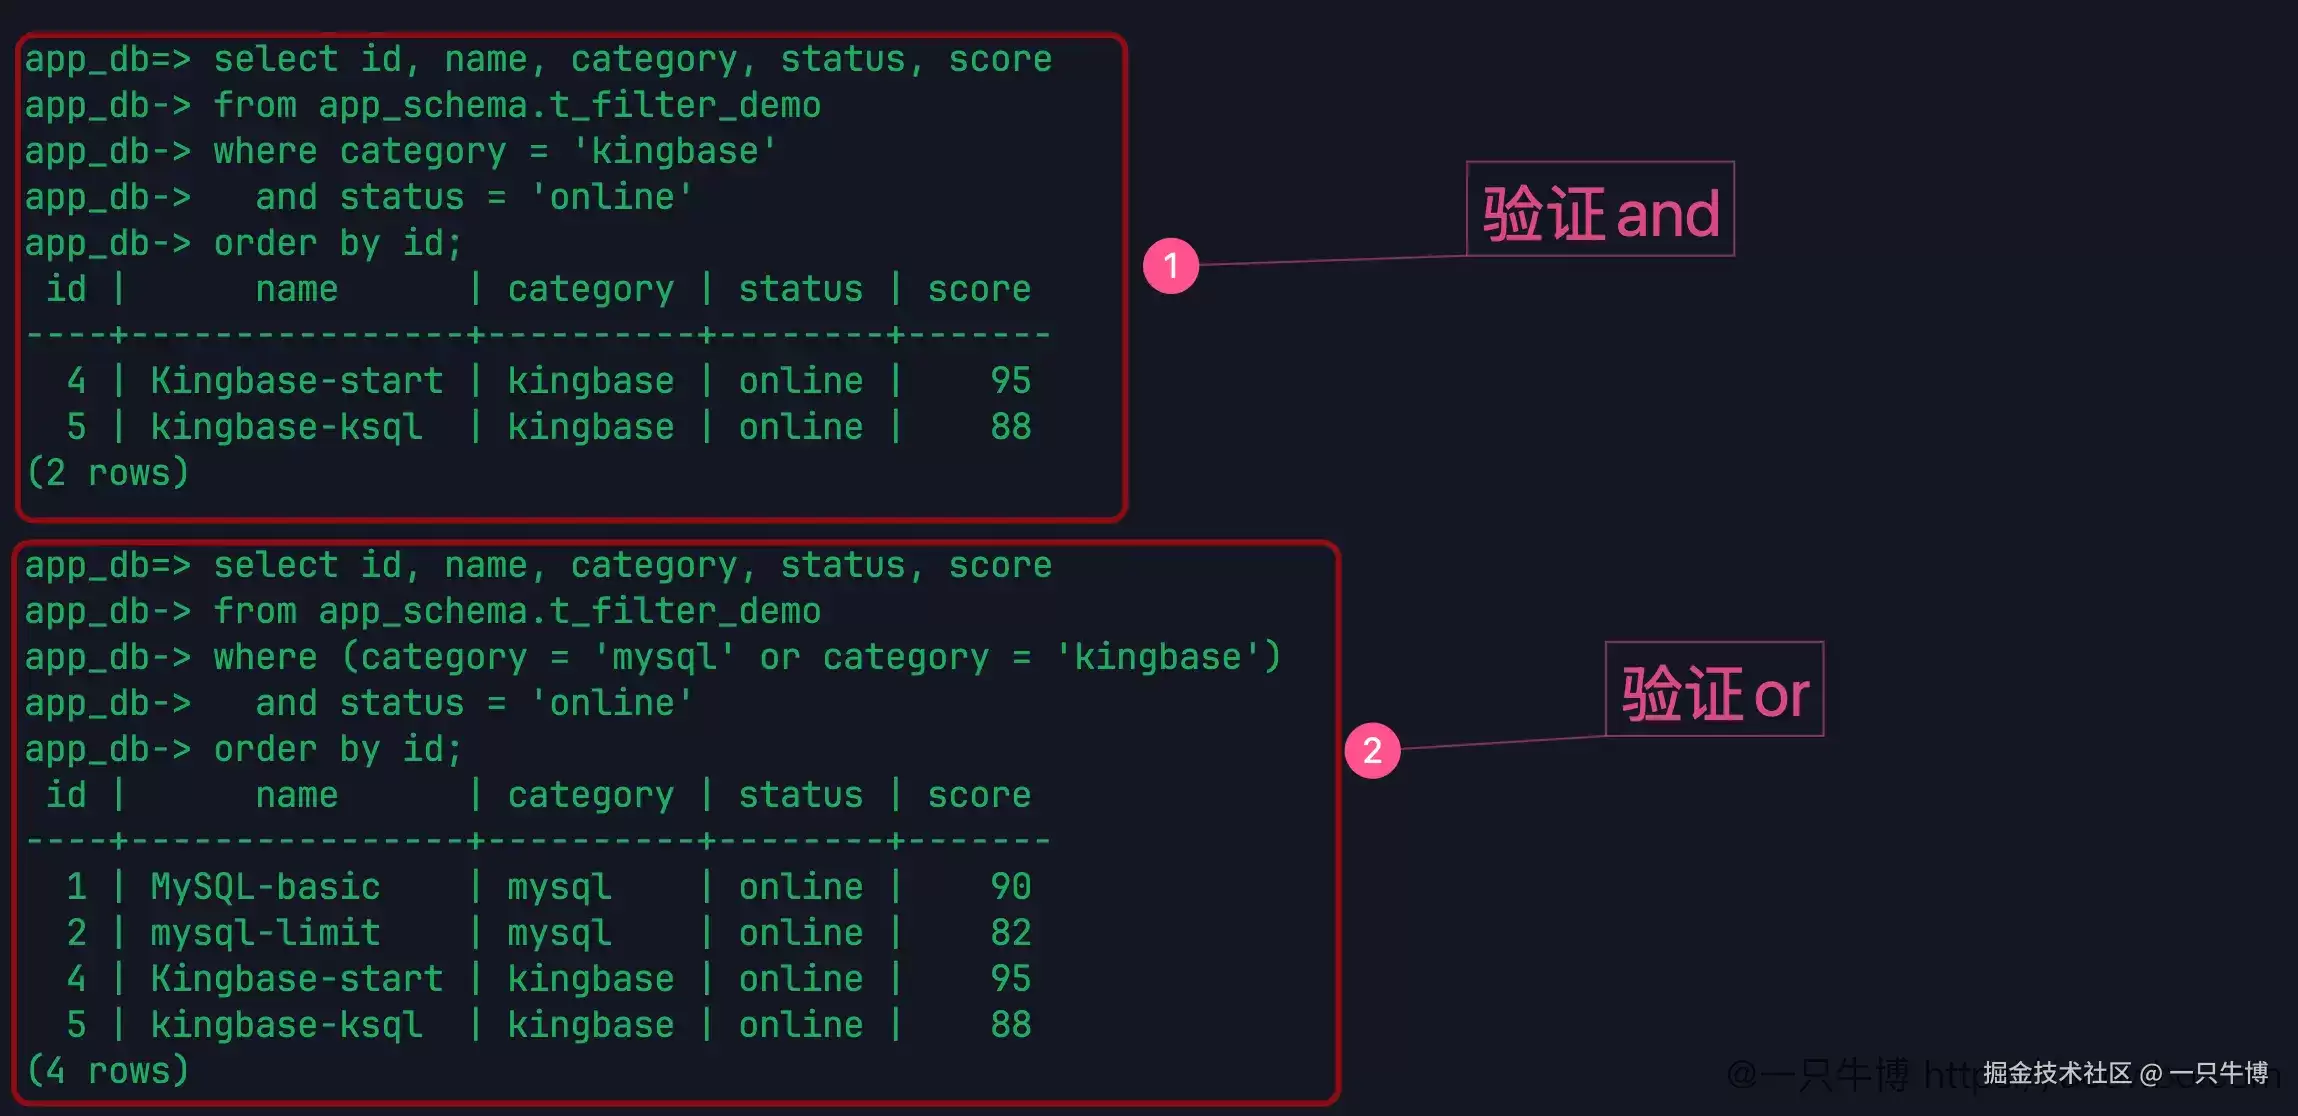
从 MySQL 迁移过来的 SQL 中,大量筛选条件都采用这种模式:一个主条件,再叠加几个状态、分类、时间范围。KingbaseES 能够运行这些基本条件并不稀奇,真正需要养成的是将复杂条件写清楚的习惯。尤其是当 or 混在一串 and 中时,括号比任何解释都更可靠。
LIKE 的大小写表现需要实测
LIKE 查询中特意使用了大小写不同的名称。先排除名字中包含 sql 的数据:
 select id, name, category
from app_schema.t_filter_demo
where name not like '%sql%'
order by id;
返回 4、6、10、11 四行数据。Kingbase-start、KINGBASE-schema、Oracle-mode、oracle-sequence 均未被 %sql% 匹配到。
接下来分别执行查询:
where name like 'MYSQL%'
和:
where name like 'mysql%'
两次结果均为 1、2、3 三行:MySQL-basic、mysql-limit、MYSQL-LIKE。这表明在当前实例中,LIKE 对于这批字符比较是大小写不敏感的。
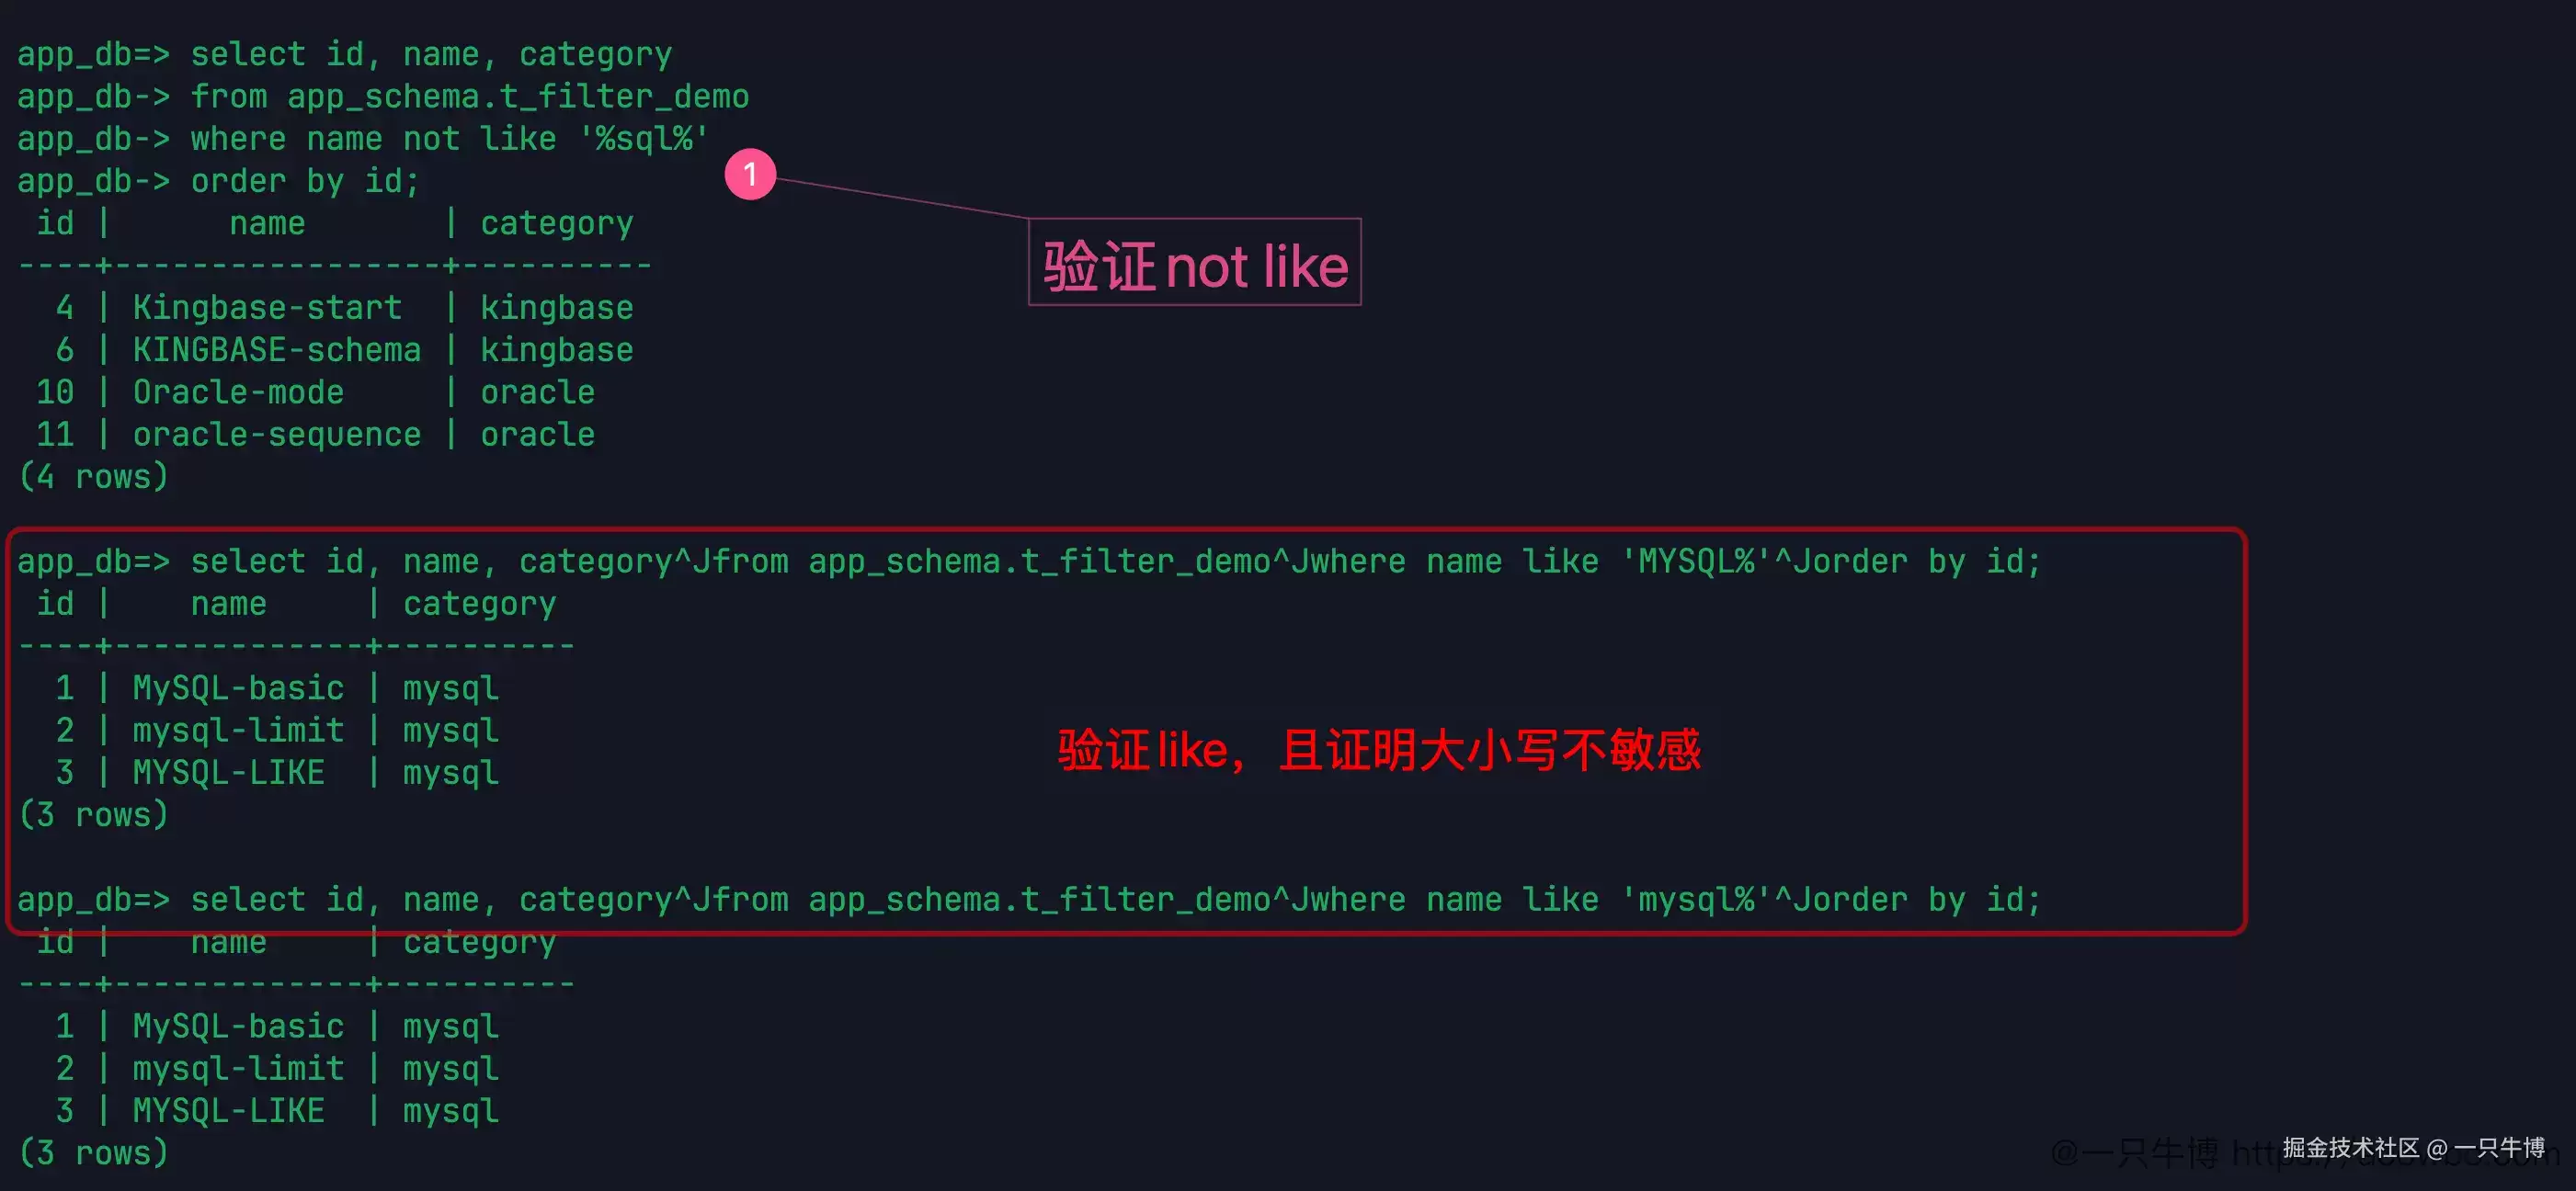
这里不要将结论扩大化。只能说在当前环境和当前初始化方式下,MYSQL% 和 mysql% 的查询结果一致。如果切换到未启用大小写不敏感的实例,或者更换字符集、排序规则,应该重新验证。在迁移 MySQL 数据库时,LIKE 通常隐藏在搜索接口中,其大小写表现最好提前确认。
还有一个细节值得注意:not like '%sql%' 将 MySQL-basic、mysql-limit、MYSQL-LIKE、SQL-where、sql-order、SQL-null 全部排除。这个结果比单纯的 like 'mysql%' 更能揭示大小写的影响,因为 %sql% 在字符串中间匹配,MySQL 中的 SQL 也被纳入匹配范围。
IN、NOT IN、BETWEEN 使用顺畅
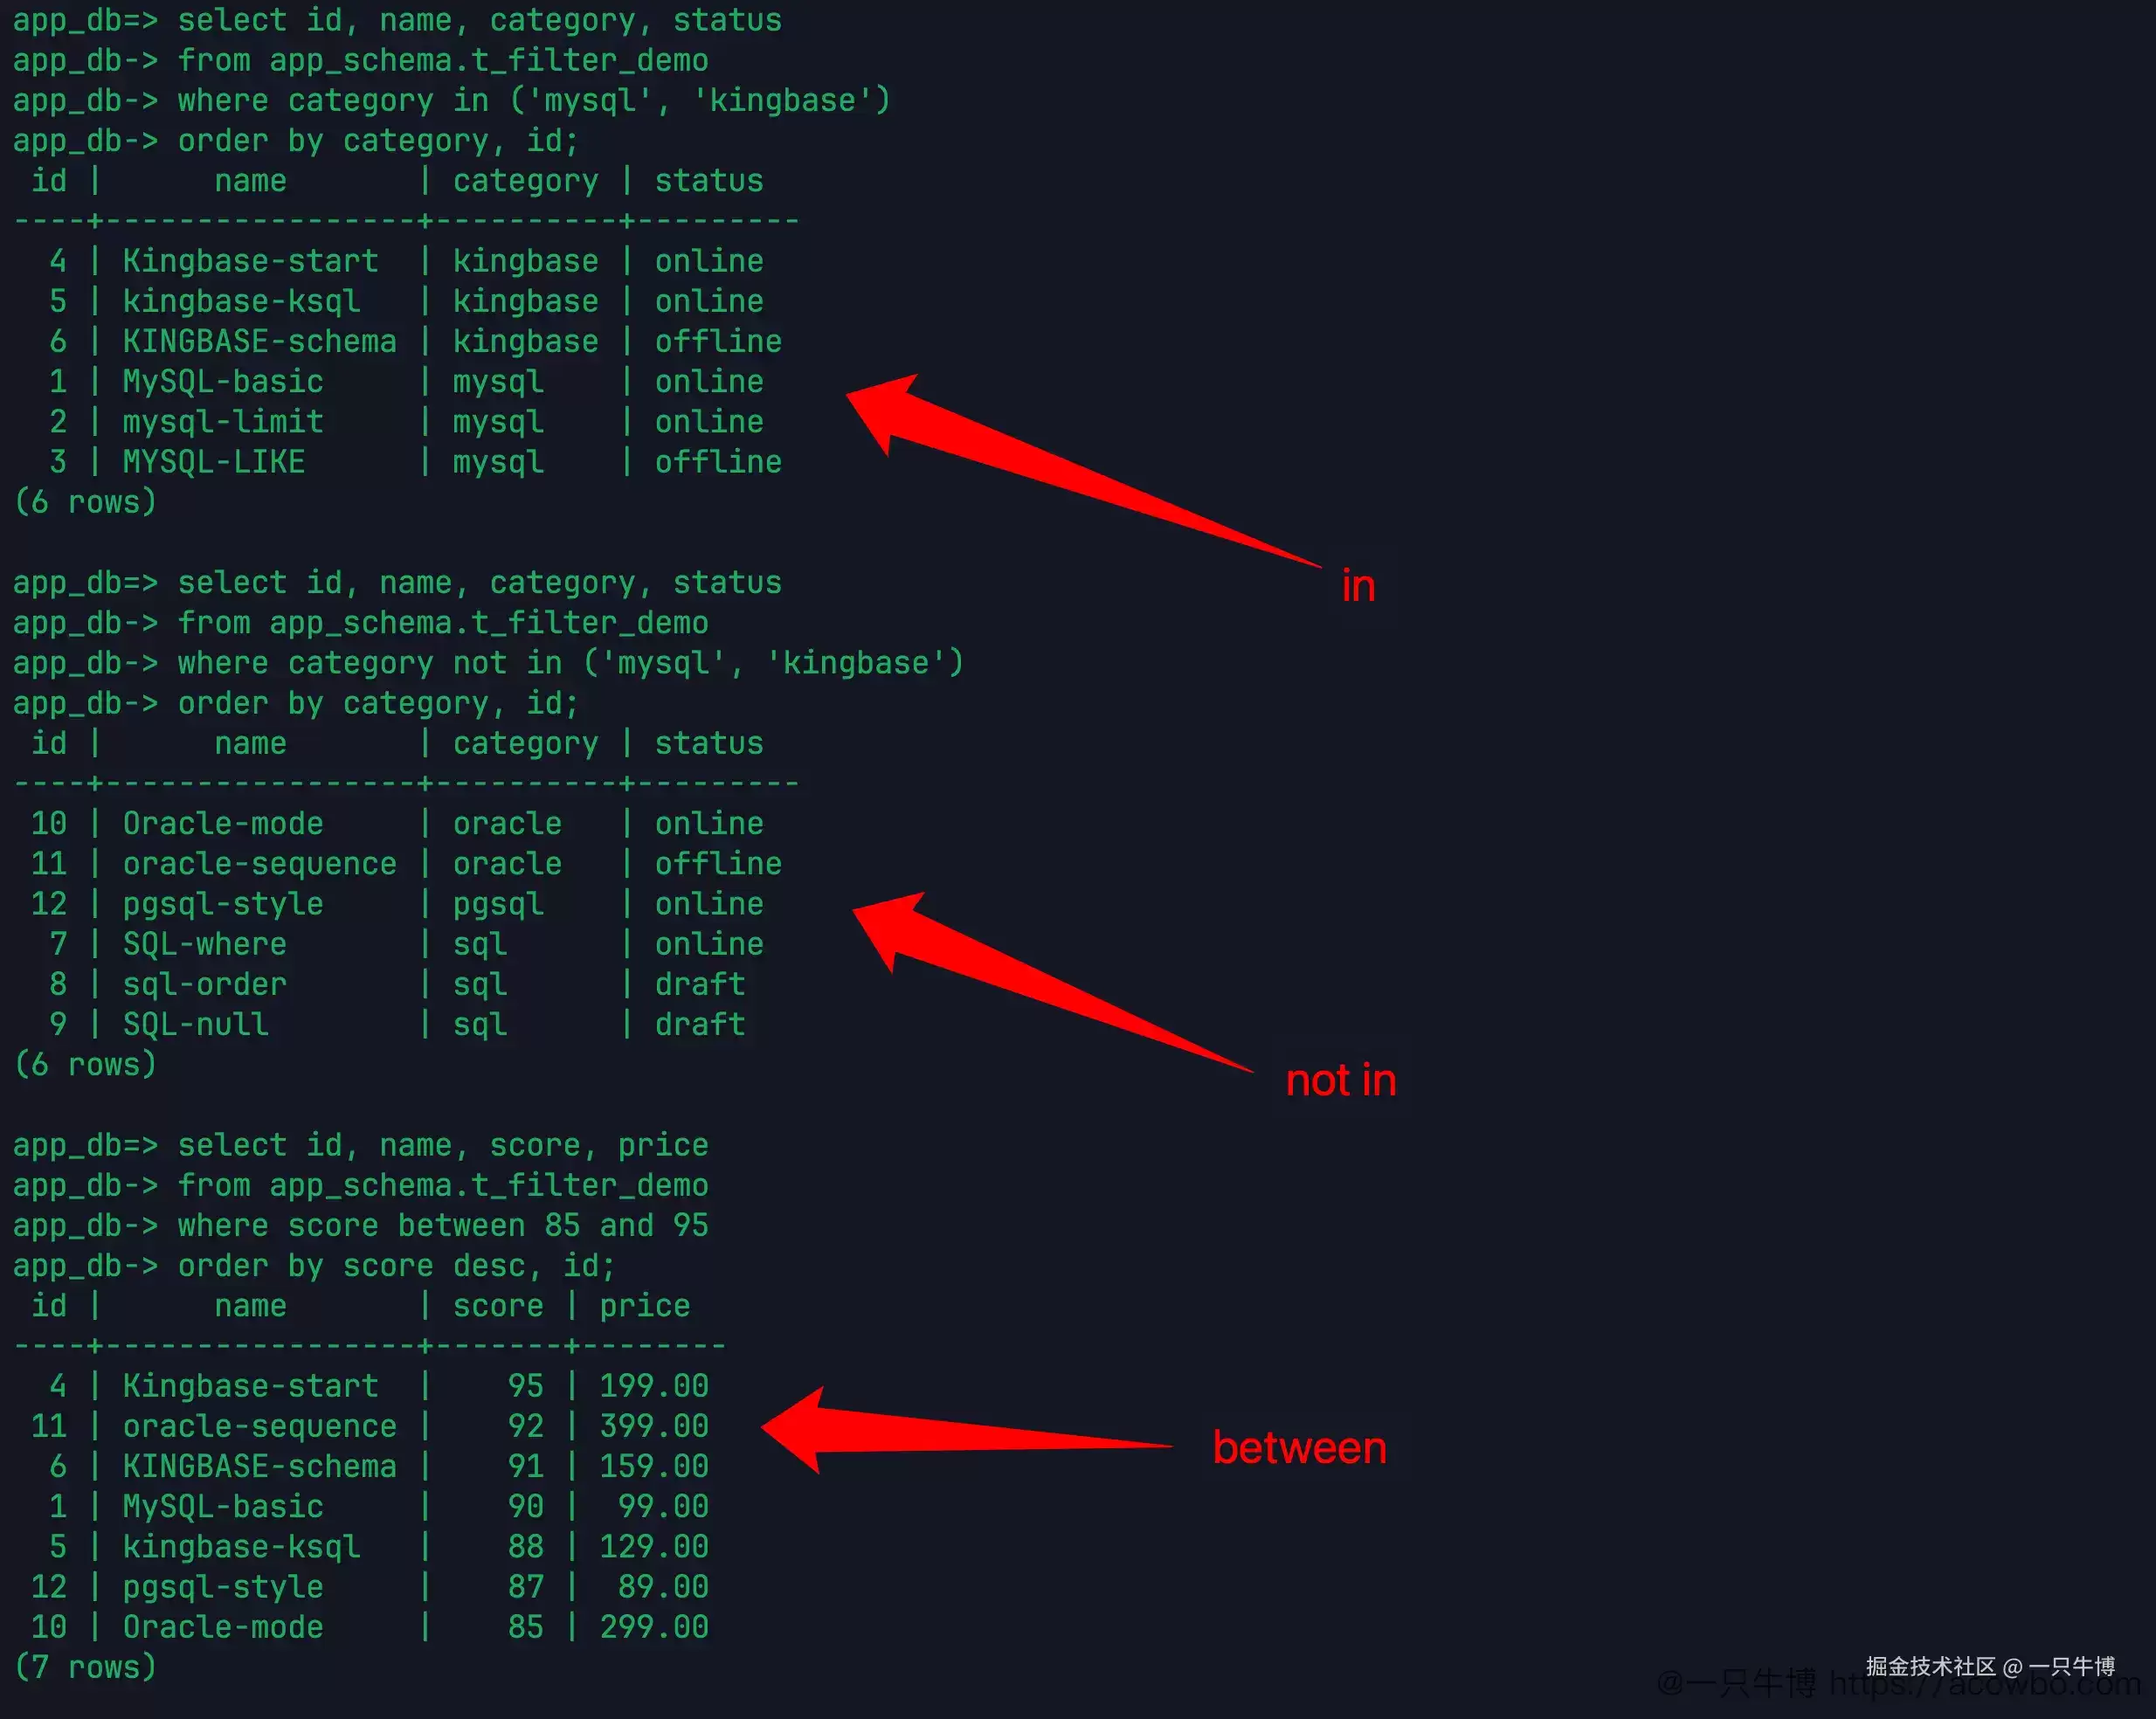
IN 适合替代一串 or 条件。本次查询 mysql 和 Kingbase 两类数据:
 select id, name, category, status
from app_schema.t_filter_demo
where category in ('mysql', 'Kingbase')
order by category, id;
返回 6 行数据,包括 3 行 kingbase 和 3 行 mysql。同样由于当前环境大小写不敏感,Kingbase 能够匹配到表中的 kingbase。
反过来使用 not in,结果即为剩余的 oracle、pgsql、sql 三类数据,共 6 行。
范围条件使用了 between 85 and 95:
 select id, name, score, price
from app_schema.t_filter_demo
where score between 85 and 95
order by score desc, id;
返回 7 行数据,包含 95 和 85 两端。between 的边界包含两端,这一点与 MySQL 中的常见理解一致。结果按 score desc, id 排序后,最高分为 Kingbase-start 的 95,最低分为 Oracle-mode 的 85。
这些条件本身难度不大。容易出问题的地方在于数据中包含 NULL 时。not in 遇到 NULL 子查询会变得复杂,不过本次仅使用固定列表,不混入子查询。NULL 的问题单独处理。
order by category, id 也有助于看清返回顺序。in 的结果并非按列表中 'mysql', 'Kingbase' 的顺序返回,而是按 SQL 中指定的排序字段返回。如果接口对返回顺序有要求,一定要将 order by 写清楚,不要依赖插入顺序或 in 列表顺序。
NULL 判断:等号无效,is null 才有效
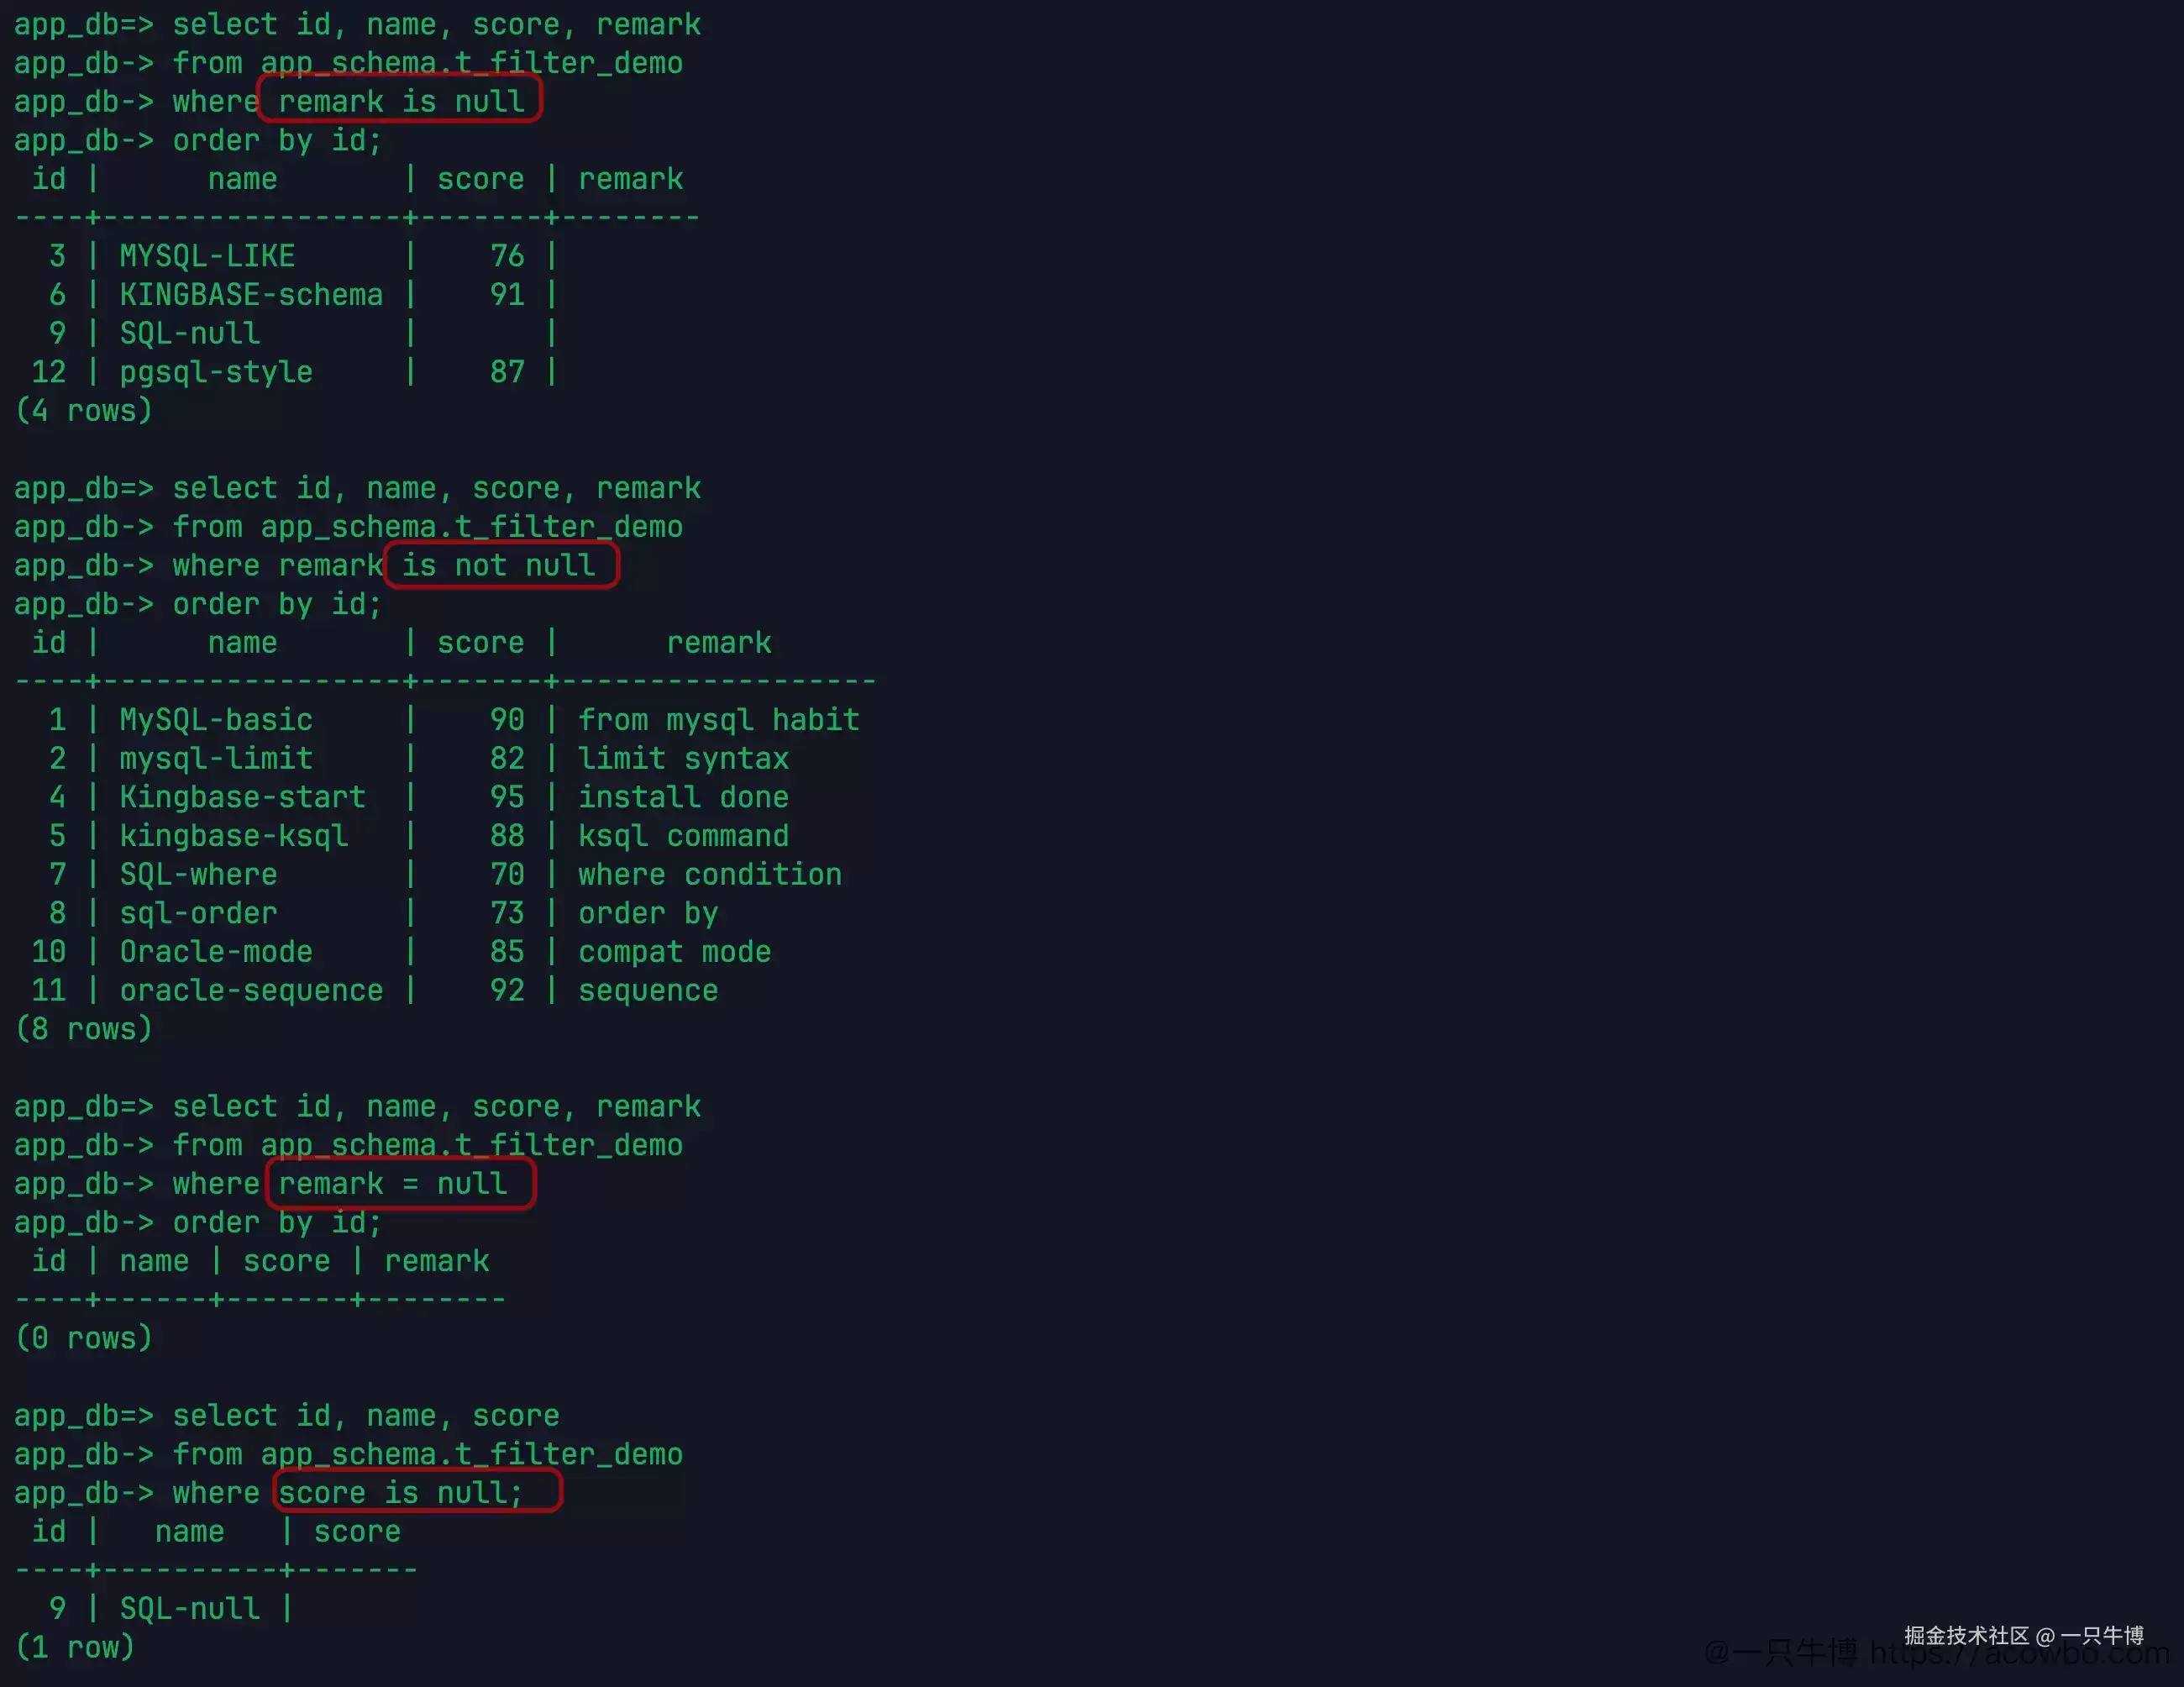
remark 字段有 4 行为 NULL。使用正确的写法查询:
where remark is null
返回 3、6、9、12 四行数据。反过来:
where remark is not null
返回 8 行数据。
再故意使用错误写法测试:
where remark = null
结果返回 0 行。这个结果非常适合用来提醒自己:NULL 不是普通值,不能使用 = 进行匹配。要查询空值,就写 is null;要排除空值,就写 is not null。
score is null 也单独执行了一次,只返回 9 号 SQL-null 数据。后续的聚合统计会用到它,因为 count(*) 和 count(score) 的结果不同。
从 MySQL 切换到 KingbaseES,NULL 的处理方式反而不需要记忆新规则,按照 SQL 标准写法来即可。真正需要改正的是一些偷懒习惯:接口拼接条件时不要将 = null 拼进去,动态 SQL 中也不要把 NULL 当作普通字符串处理。
remark 和 score 两个字段都包含了 NULL,但效果不同:remark 是文本备注,适合验证空值筛选;score 是数字,后续会参与聚合计算。同样是 NULL,到了统计函数中就会影响计数和平均值,这比单纯查出空行更容易在报表中踩坑。
排序和 LIMIT 组合使用
取出分数最高的 5 行数据:
 select id, name, category, score
from app_schema.t_filter_demo
where score is not null
order by score desc, id
limit 5;
返回结果为 4、11、6、1、5,对应分数 95、92、91、90、88。这里先使用 score is not null 排除掉 NULL 值,再按分数倒序排列,最后加 id 作为兜底排序字段。
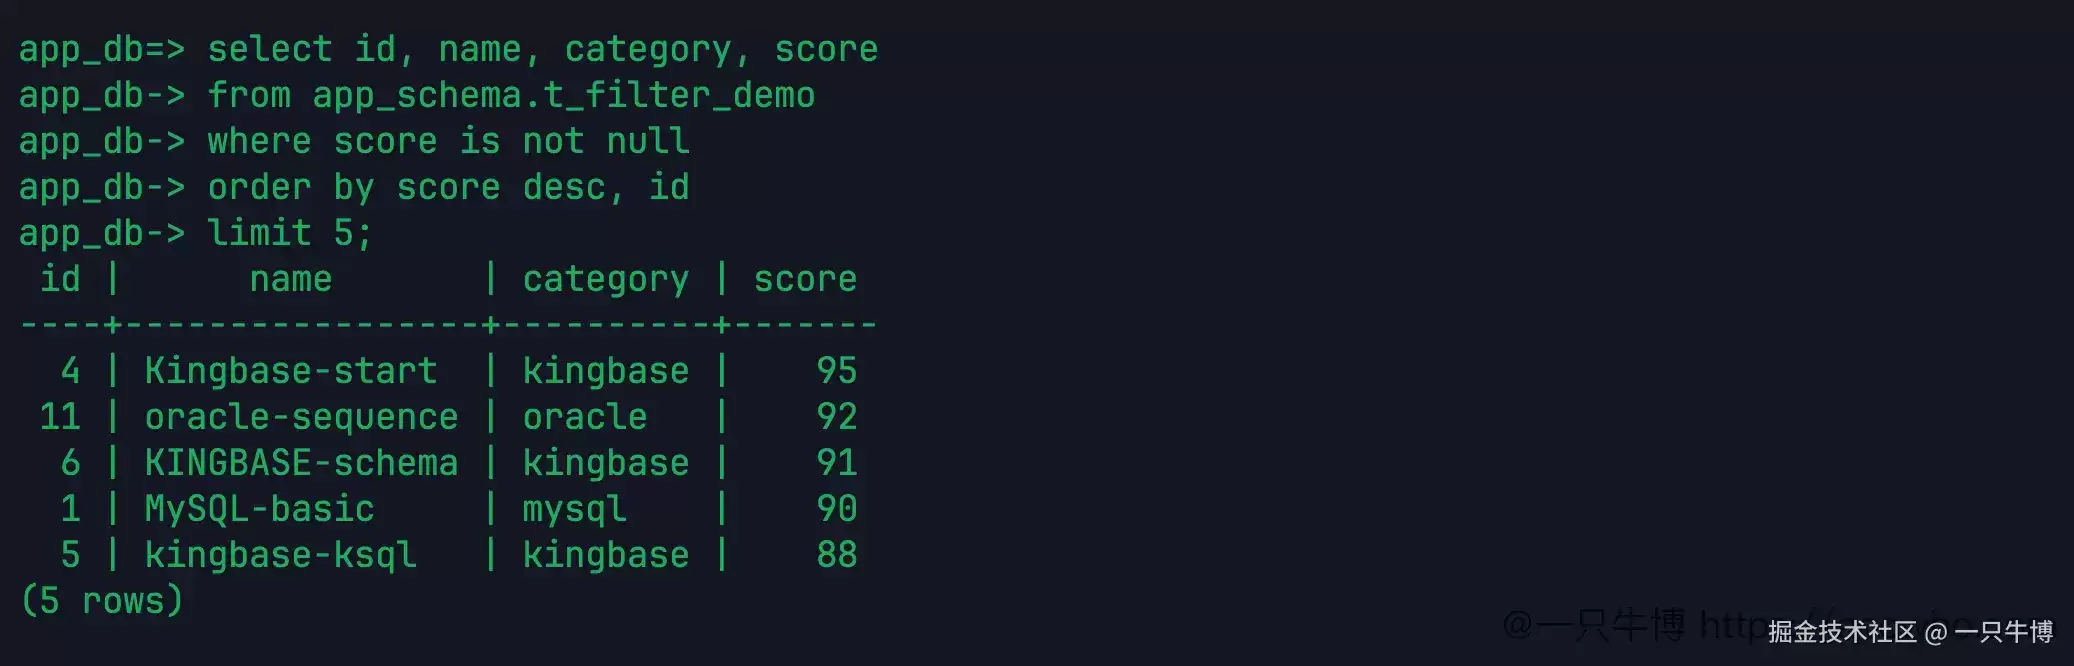
limit 语法前面已经单独验证过,这里放在条件查询中更贴近日常使用场景。实际接口中很少只写 limit 5,更多是先筛选、再排序、最后限制条数。如果排序字段只有一个,当出现同分时,分页结果可能不稳定;多加一个唯一字段做兜底,结果更容易复现。
本次数据中前 5 名没有同分情况,id 兜底看起来不太明显,但仍然应该写上。等数据量增大后,同一分数出现多行是很常见的。分页接口缺少一个稳定的排序字段,问题通常不会立即暴露,而是在翻页时出现重复行或漏行。
聚合函数自动跳过 NULL
先对全表进行一次基础统计:
 select
  count(*) as total_count,
  count(score) as score_count,
  min(score) as min_score,
  max(score) as max_score,
  a vg(score) as a vg_score
from app_schema.t_filter_demo;
结果中 total_count 为 12,score_count 为 11。相差的那一行,正是 score 为 NULL 的 9 号数据。min(score) 为 70,max(score) 为 95,a vg(score) 为 84.45454545454545。平均值基于 11 个非 NULL 分数计算,而不是按 12 行硬除。
再按状态分组统计:
 select status, count(*) as row_count
from app_schema.t_filter_demo
group by status
order by status;
返回 draft=2、offline=3、online=7。
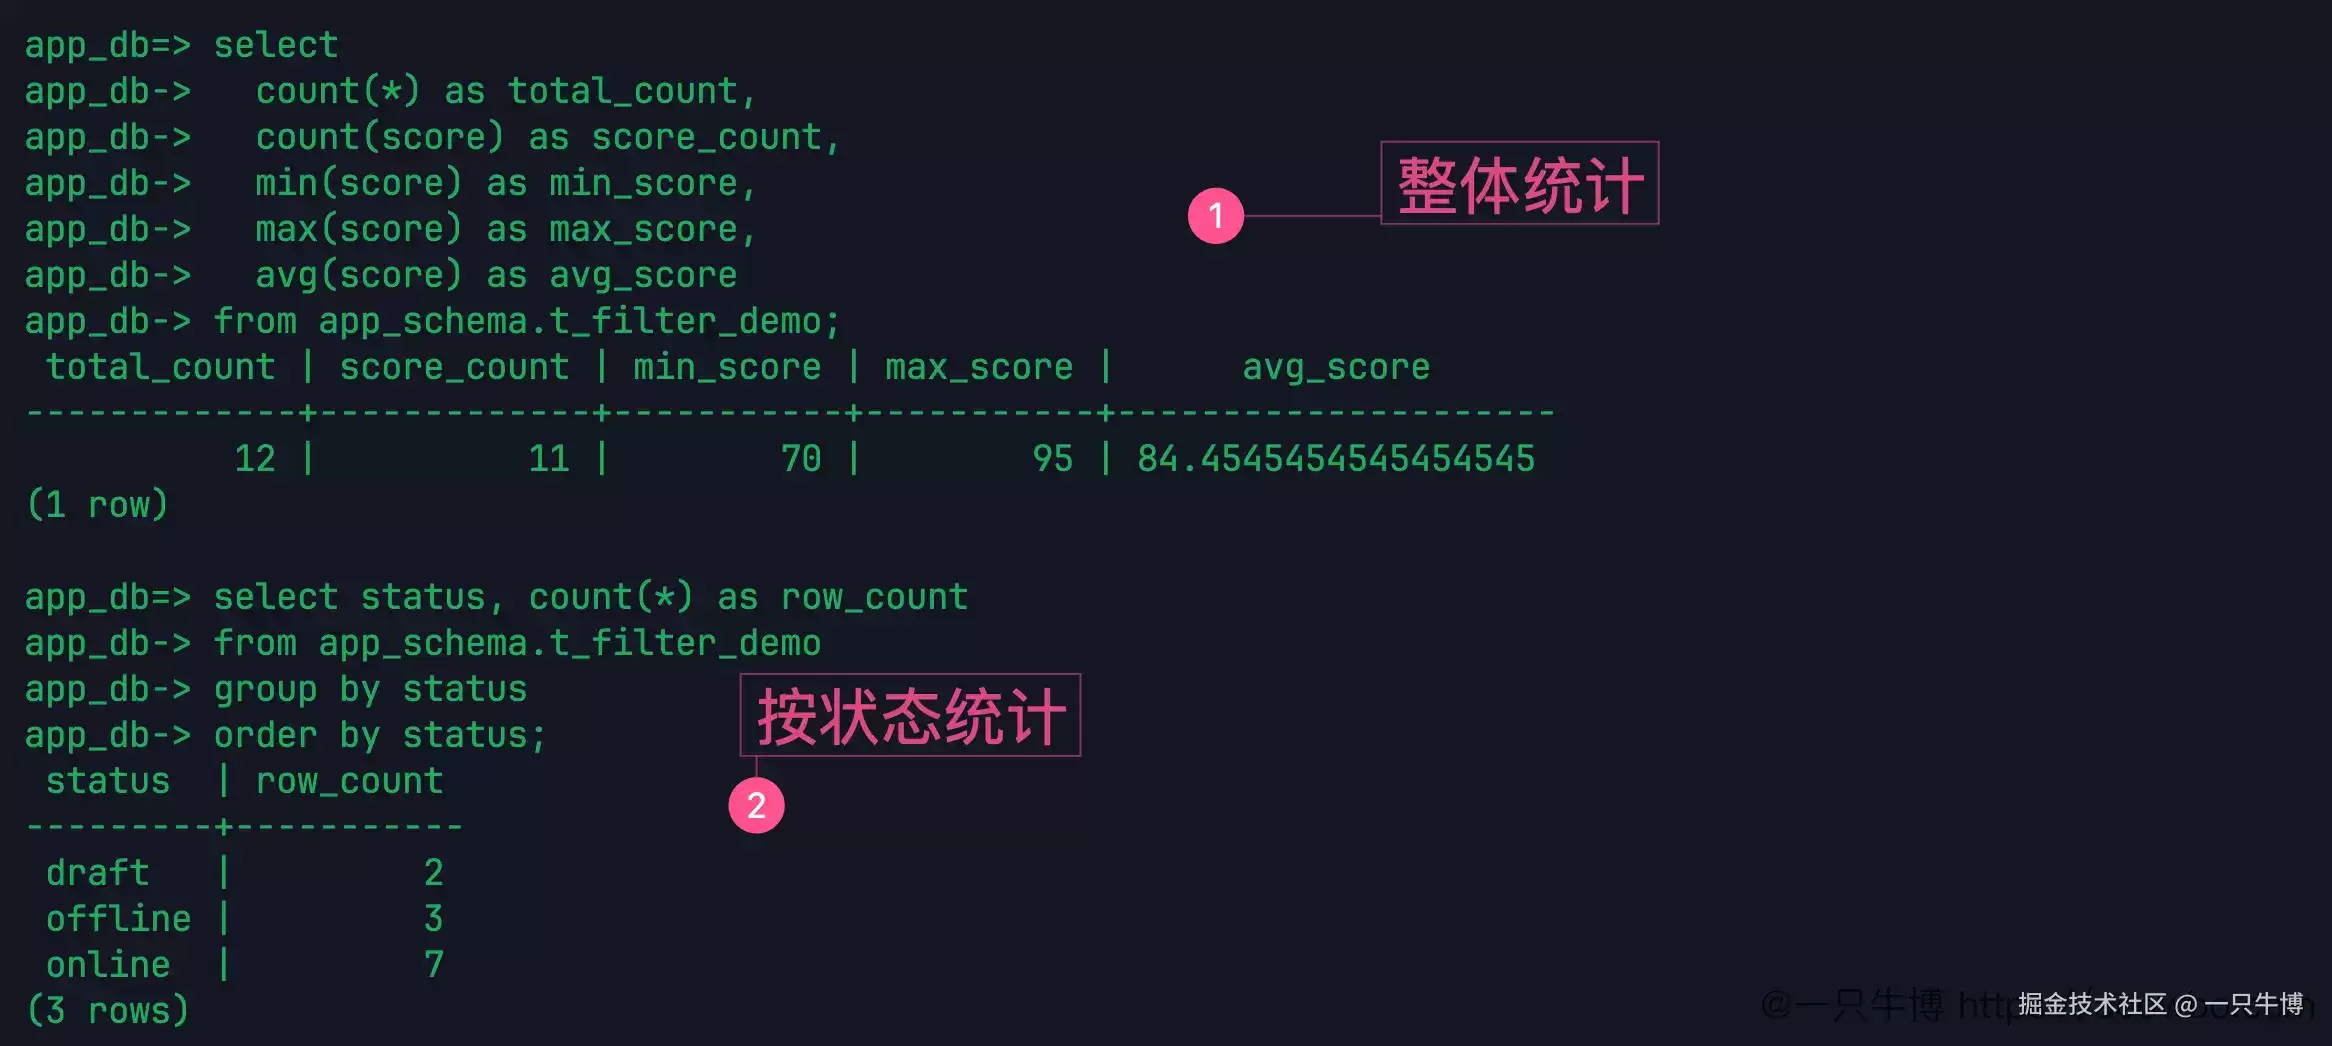
这里与 MySQL 中的常见用法差异不大。真正需要关注的是 count(*) 和 count(字段) 的区别:前者统计行数,后者只统计该字段非 NULL 的行数。接口中如果将两者混用,统计结果会存在偏差。
状态统计结果也顺便验证了之前的插入数据:2 行草稿、3 行下线、7 行在线,合计正好 12 行。进行这类小实验时,分组结果可以作为一次反向校验,避免后续使用本身就存在问题的数据继续验证。
HAVING:分组后的过滤条件
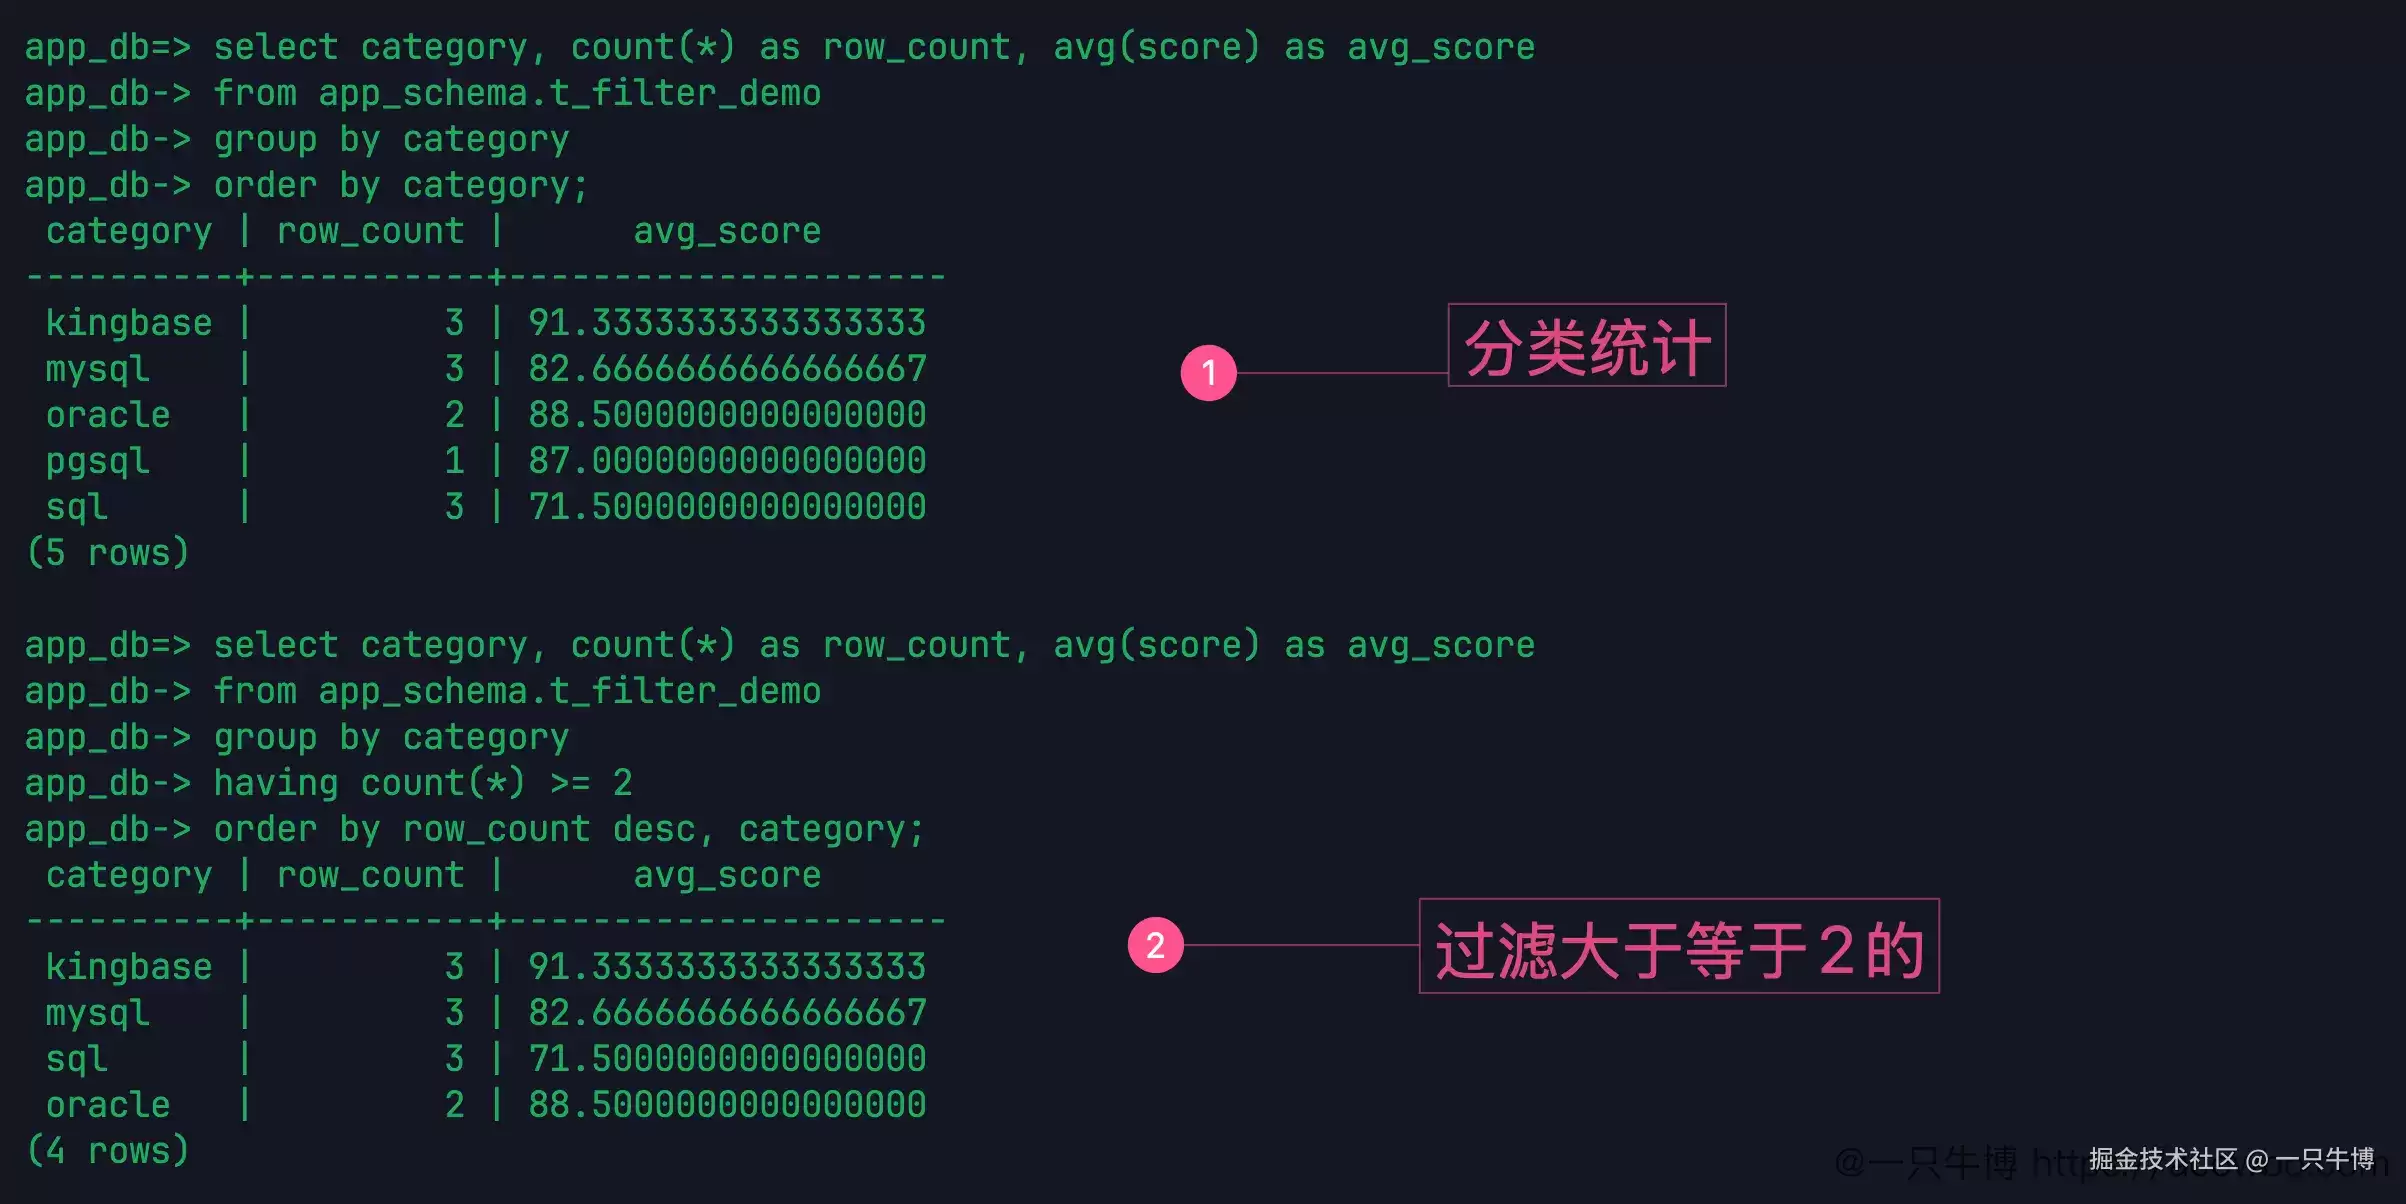
最后按分类进行统计:
 select category, count(*) as row_count, a vg(score) as a vg_score
from app_schema.t_filter_demo
group by category
order by category;
结果包含 5 个分类:kingbase 3 行,平均分约 91.33;mysql 3 行,平均分约 82.67;oracle 2 行,平均分 88.50;pgsql 1 行,平均分 87;sql 3 行,平均分 71.50。sql 分类中有一行 score 为 NULL,因此平均分仅按 70 和 73 计算。
再加上过滤条件:
ha ving count(*) >= 2
pgsql 被过滤掉,只保留行数大于等于 2 的分类。where 是分组前过滤明细行,ha ving 是分组后过滤聚合结果,这一区别在报表 SQL 中非常常见。
这组查询运行完毕后,日常 WHERE 条件的基本用法就有了清晰的认识。等值、不等值、and/or、like、in、between、NULL 判断、排序、限制条数、聚合和 ha ving,在当前 V009R001C010 环境中均能按预期工作。需要特别标记的有三点:当前实例大小写不敏感,因此 LIKE 和 category = 'Kingbase' 的表现不能脱离环境复述;NULL 只能使用 is null / is not null;聚合函数处理 NULL 时要看清 count(*) 和 count(字段) 的差别。
ha ving count(*) >= 2 过滤的是分组后的行数,因此 sql 分类虽然有一个分数为 NULL,但仍然被保留下来——它有 3 行明细数据。a vg(score) 只按非 NULL 分数计算,行数和平均值各算各的,这一点从 sql 分类的 3 行数据、平均分 71.50 可以清晰看出。
将这些基础条件先跑明白,再去看 JOIN、子查询、窗口函数或备份恢复等内容,心里会踏实很多。SQL 迁移最怕的不是语法复杂,而是基础判断没有经过实测就默认“差不多”。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。