

精选Watchdog、Pydub、Selectolax等9个Python第三方库,分别用于文件变化监控、音频处理与转换、HTML内容解析、时区自动转换、交互式调试、日志管理、CLI命令生成、测试数据填充及轻量级定时任务调度,这些工具能极大提升开发效率,有效减少重复劳动与Bug。
个Python第三方库推荐,不用AI也能多一个团队
作者:技术拾光
时间:2026-06-27
浏览:179
文章目录
都AI时代了,谁还在花时间写重复的底层逻辑,浪费时间不说,还容易出Bug。优秀的开发者,通常会优先寻找那些经过验证的开源工具,直接站在前人的肩膀上解决问题。
这里精选了9个实用的Python第三方库,涵盖文件监控、音频处理、解析、日志以及任务调度等常见场景。合理利用这些工具,能显著优化代码库,让团队把精力集中在核心业务逻辑上。
Watchdog:高效的Python文件监控方案
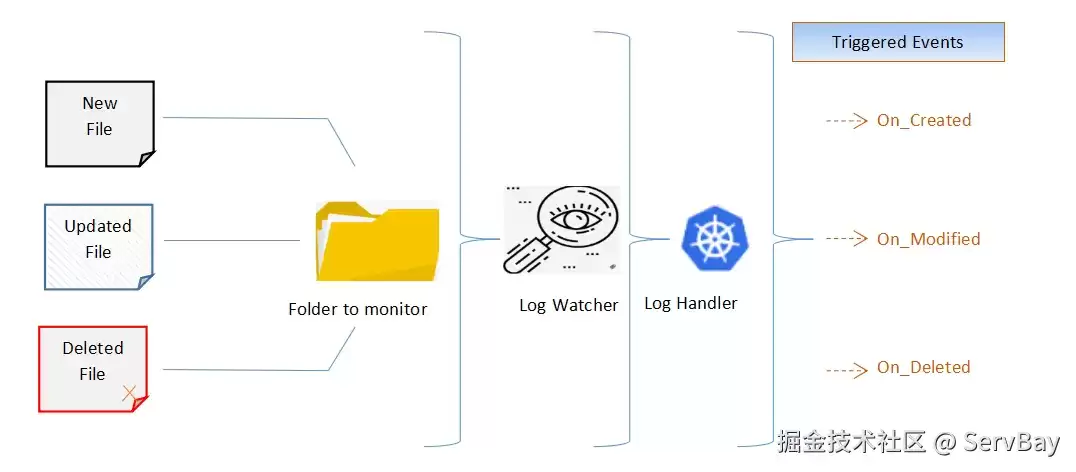
数据处理或日志清理时,经常需要实时获取特定目录下的文件变化。如果用循环加延时的老办法去轮询检测,不仅浪费CPU资源,反应还总是慢半拍。
Watchdog直接对接操作系统的内核事件(比如Linux的inotify或Windows的ReadDirectoryChangesW),文件发生创建、修改或删除时,会立即触发回调,运行开销极低。
import time
from watchdog.observers import Observer
from watchdog.events import FileSystemEventHandlerclass JsonConfigHandler(FileSystemEventHandler):
    def on_modified(self, event):
        # 仅监控json文件的修改事件
        if event.src_path.endswith('.json'):
            print(f"检测到配置文件修改,文件路径为 {event.src_path}")observer = Observer()
# 监控当前目录下的config文件夹
observer.schedule(JsonConfigHandler(), path="./config", recursive=False)
observer.start()try:
    while True:
        time.sleep(1)
except KeyboardInterrupt:
    observer.stop()
observer.join()
- 使用建议:如果监控的是网络挂载盘(比如NFS卷),受操作系统底层限制,事件通知可能会有延迟或丢失,在分布式存储环境下需要谨慎测试。
Pydub:告别复杂命令的Python音频处理库
处理音频数据时,调用底层ffmpeg命令行虽然能解决问题,但维护那些拼装好的shell字符串,会让代码变得又长又难看,调试起来也费劲。
Pydub封装了底层的音频解析细节,提供了简洁的Python接口。几行代码就能搞定音频合并、音量调整、格式转换这些日常操作。
from pydub import AudioSegment# 导入不同的音频文件
intro = AudioSegment.from_mp3("intro.mp3")
podcast = AudioSegment.from_mp3("podcast.mp3")# 合并两段音频,并为结尾添加2000毫秒的淡出效果
combined_audio = intro + podcast
final_output = combined_audio.fade_out(2000)final_output.export("final_podcast.mp3", format="mp3")
- 使用建议:使用前,系统环境变量里必须正确配置好ffmpeg的路径,否则它处理不了mp3这类非WA V格式的音频。
Selectolax:速度大幅提升的BeautifulSoup替代方案
做爬虫或数据挖掘项目时,如果要解析海量网页数据,BeautifulSoup的解析速度在大规模高并发场景下很容易成为瓶颈。
Selectolax底层采用C语言编写的Modest或Lexbor引擎,在保持CSS选择器语法习惯的同时,解析速度和内存占用都表现出色,特别适合处理复杂HTML文档。
from selectolax.parser import HTMLParserhtml_content = """


        Python入门教程
        99.00


"""tree = HTMLParser(html_content)
# 使用CSS选择器快速定位元素并提取文本
title_node = tree.css_first(".title")
price_node = tree.css_first(".price")if title_node and price_node:
    print(f"解析结果为 书名 {title_node.text()}, 价格 {price_node.text()}")
-
使用建议:Selectolax更专注于解析效率,社区文档和周边生态相对BeautifulSoup少一些,遇到复杂解析场景时,得仔细阅读官方文档里的选择器规范。
Pendulum:解决复杂时区转换的Python日期库
Python原生的datetime模块,处理时区转换、夏令时、跨区域时间差时,代码写起来总是很繁琐,一不小心还会引入时区Bug,弄不好就让业务受损。
Pendulum完全兼容原生datetime,同时提供了更直观的时间跨度计算和时区切换功能,避免了那些烦人的转换步骤。
import pendulum# 获取当前上海时间
now = pendulum.now("Asia/Shanghai")# 增加2周零3天
future_time = now.add(weeks=2, days=3)# 计算时间间隔
time_difference = future_time.diff(now)
print(f"相差天数共 {time_difference.in_days()} 天")
print(f"格式化日期为 {future_time.to_date_string()}")
- 使用建议:涉及金融、账单、跨国排程等对时间精度要求极高的场景,用Pendulum可以显著降低时区计算出错的概率。
IceCream:替代传统print的Python调试工具
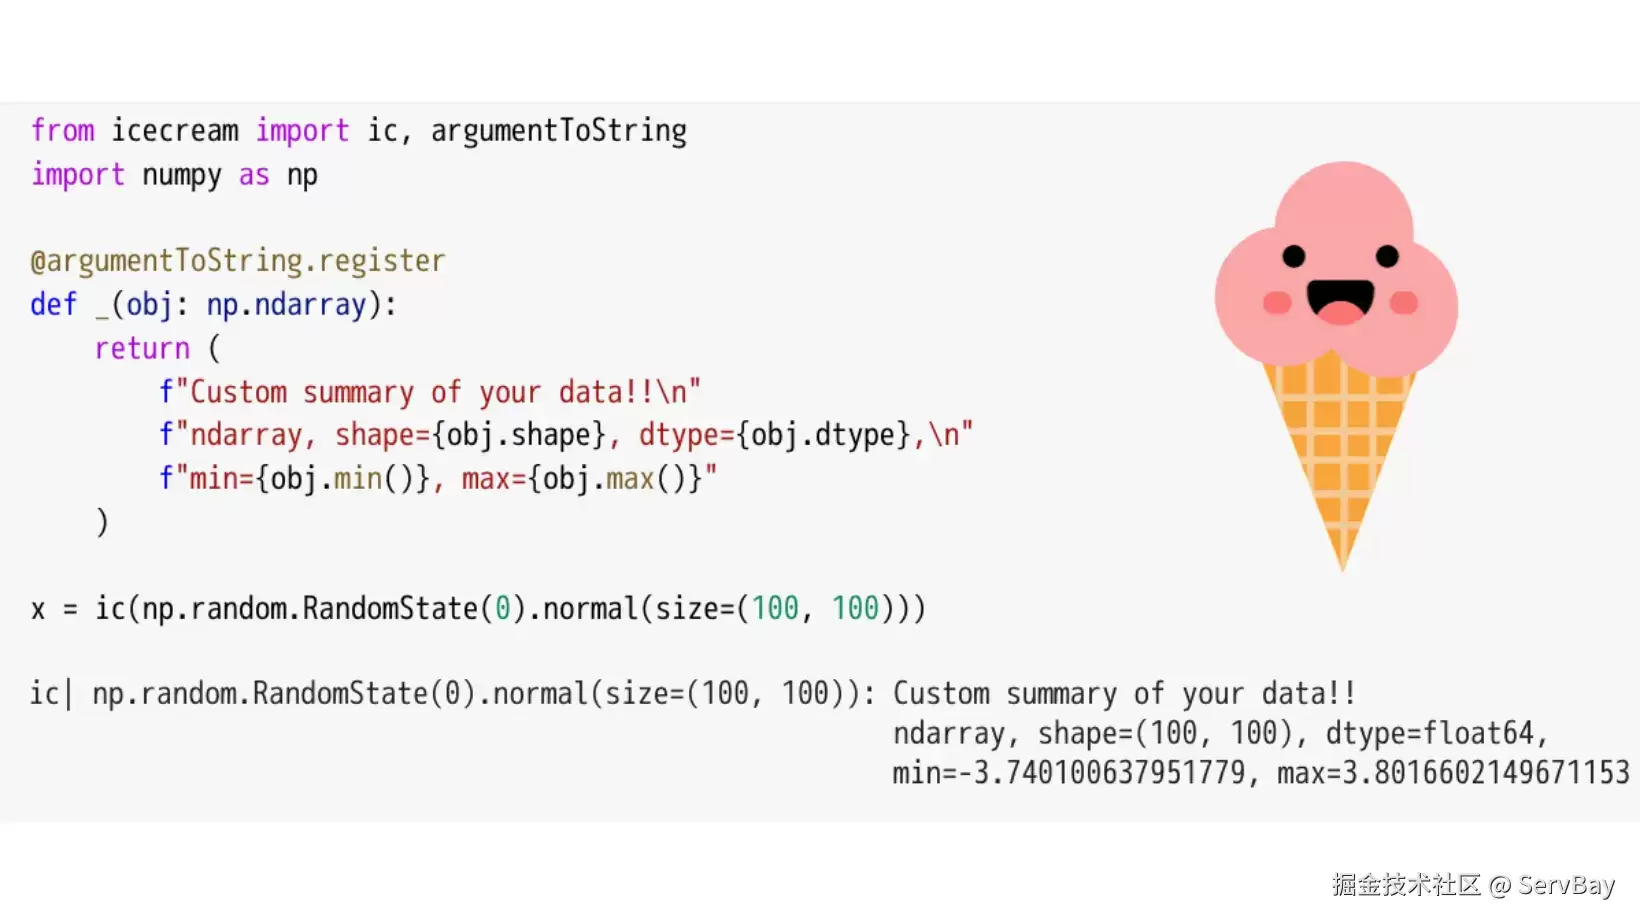
很多开发者习惯在代码里穿插print(value)来定位问题,但输出的内容如果没有上下文,在终端里很难分辨它对应的是哪个变量,更不清楚是在哪一行打印的。
IceCream专为本地开发和排查问题设计,调用时不仅输出变量值,还能自动带上变量名、函数名以及所在的文件行号。
from icecream import icuser_data = {"id": 101, "role": "admin"}
# 自动打印变量名、所在行以及内容
ic(user_data)def get_discount(level):
    return 0.15 if level > 5 else 0.05# 打印函数调用结果和传入参数
ic(get_discount(8))
- 使用建议:这个库主要用于本地调试阶段,项目正式部署到生产环境之前,记得把它换成标准的日志系统。
Loguru:开箱即用的现代Python日志库
标准库logging的配置实在繁琐,对中小型项目来说,光写几十行初始化代码来实现日志颜色分类、文件自动轮转和压缩,就已经够让人头疼的了。
Loguru精简了配置流程,API设计极简,默认就开了美观的控制台输出,还支持自动归档和错误回溯。
from loguru import logger# 添加日志文件,设置每天凌晨自动切分归档
logger.add("app_error.log", level="ERROR", rotation="00:00")logger.info("系统启动成功,核心模块已加载")
logger.error("数据库连接超时,正在尝试自动重连")
- 使用建议:在多模块协作的超大型项目里,如果其他依赖库强绑定了标准库的logging,可以用Loguru提供的适配器进行全局劫持和重定向。
Typer:快速生成CLI命令行工具
给开发团队写辅助脚本时,命令行的参数校验和帮助文档通常要花不少心思去处理。
Typer基于Python 3的类型提示功能,能自动把普通的Python函数包装成规范的CLI命令行工具,连--help文档都是自动生成的。
import typerapp = typer.Typer()@app.command()
def backup(source_dir: str, target_dir: str, force_overwrite: bool = False):
    if force_overwrite:
        print(f"执行强制覆盖备份,从 {source_dir} 到 {target_dir}")
    else:
        print(f"执行常规备份,从 {source_dir} 到 {target_dir}")if __name__ == "__main__":
    app()
- 使用建议:Typer基于Click库构建,完美支持自动补全等进阶功能。不过在超轻量、无外部依赖的单文件脚本里,原生argparse仍然是更轻量的方案。
Faker:自动生成测试数据的得力助手
前后端联调或者写单元测试的时候,构造各种逼真的用户数据,真是一件枯燥又麻烦的事。
Faker支持高度本地化的数据生成,能快速输出姓名、地址、电子邮箱、公司、职业这些信息。
from faker import Faker# 初始化中文数据源
generator = Faker("zh_CN")# 批量生成3条模拟数据
for _ in range(3):
    profile = {
        "姓名": generator.name(),
        "公司": generator.company(),
        "职位": generator.job(),
        "邮箱": generator.free_email()
    }
    print(profile)
- 使用建议:生成的数据属于伪随机数据,只能用于非生产环境的功能测试或性能压测,不能替代真实业务逻辑里的复杂校验。
APScheduler:应用内轻量级Python定时任务框架
很多时候,我们只需要在应用里定期执行一小段清理工作或状态同步。要是为了这点事去引入外部的Celery,或者配置操作系统的Crontab,运维部署的复杂度一下就上来了。
APScheduler是一个运行在Python进程内的任务调度框架,支持秒级、分钟级、固定间隔以及类似Cron的定时设置。
import time
from apscheduler.schedulers.background import BackgroundSchedulerdef clean_expired_sessions():
    print("定时任务触发,正在清理过期会话数据")scheduler = BackgroundScheduler()
# 设置每隔10秒钟执行一次清理函数
scheduler.add_job(clean_expired_sessions, 'interval', seconds=10)
scheduler.start()try:
    while True:
        time.sleep(1)
except (KeyboardInterrupt, SystemExit):
    scheduler.shutdown()
- 使用建议:这个调度器是单进程方案。如果项目部署在多实例的集群或容器云环境下,定时任务可能会在多个机器上重复执行,这时需要外加一个锁机制,或者直接切换到外部分布式调度系统。
总结
在现代软件工程实践中,优化开发效率,很多时候就是靠合理精简底层细节。这篇文章介绍的9个第三方库,从文件监控(Watchdog)、音频处理(Pydub)、高效解析(Selectolax),到调试与日志(IceCream、Loguru)、命令行工具(Typer)、测试数据生成(Faker)以及定时任务管理(APScheduler),分别在各自的应用场景里解决了常见的开发痛点。根据项目的实际规模和架构,选对合适的工具,离更敏捷、更稳定的项目交付就更近一步。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章