

人工智能进化与数据表达方式深度绑定,数据资源建设须从AI需求出发,充分重视中文文字形象结构的独特性、行业专业数据的高价值,同时严守数据流通中的安全边界,这是AI数据治理的核心要求。
徐雷:以AI需求驱动数据资源建设
作者:技术拾光
时间:2026-06-17
浏览:196
文章目录
人工智能进化与数据表达:中文数据特性成关键突破口
先说一个核心判断:人工智能的进化,本质上和语言、文字以及数据的表达方式深度绑定。日前在四川自贡举行的“2026人民数据大会”上,上海市人工智能战略咨询专家委员会荣誉委员、上海交大讲席教授、欧洲科学院院士徐雷就特别点出了这一点——推进数据资源建设,得从AI的真正需求出发,尤其要重视中文数据的独特性、行业专业数据的价值,以及数据流通中的安全边界。
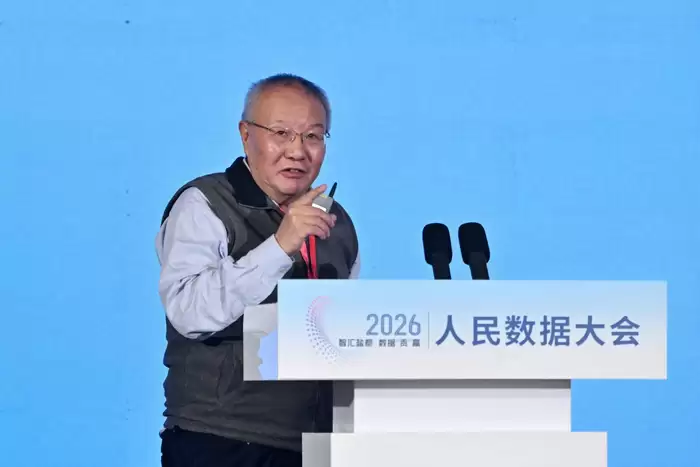
中文数据为何特殊?东西方文字底层逻辑大不同
为什么说中文数据特殊?徐雷教授对比了东西方文字的底层逻辑:西方拼音文字逐步抽象为符号语言、数学语言,再延伸到计算机语言,路径很直。但中文不一样,每个字本身就有形象结构,一个字往往同时包含符号、内容和意义。这种特点,对于AI的数据表达和模型训练,其实藏着不小的启发。
数据建设新思路:让中文语义结构融入模型训练
落实到数据建设上,现在处理中文数据时,普遍做法是先把它转成编码、token之类的中间形式。但如果能更进一步,把中文文字和语义结构的特质融入数据组织和模型处理过程,训练效果和应用落地可能会有明显提升。换句话说,数据工作不能只停留在传统大数据的思路上,得想清楚:这些数据能不能真正支撑模型训练、业务推理和实际任务?
专业数据才是AI落地的命门,安全边界需同步筑牢
另一个关键点在于——真正有价值的数据库,不在通用语料里,而在行业和专业场景中。徐雷指出,通用数据的重要性当然不可否认,但越往行业应用深处走,专业数据就越成为企业和行业的命门。这其实也给数据交易、共享和合作提了个醒:边界在哪里?
尤其是在智能设备、机器人等持续采集真实环境数据的场景里,数据采集、使用和流转过程中的风险防范必须跟上。推动数据要素流通、释放价值,既要看到行业专业数据对AI的支撑作用,也要守住安全的底线。
面向AI新阶段:数据建设应围绕模型、场景与产业需求
面向人工智能发展的新阶段,数据建设的方向已经很明确:围绕模型需求、场景需求和产业落地需求,在保障安全和权益的前提下,让高价值数据真正服务于AI创新。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。