

AMD开源AI服务器项目Lemonade10.7版本首次集成英伟达CUDA后端,补齐硬件缺口,实现跨厂商本地AI推理能力。此外,增加了CUDA后端、GPU检测功能及Linux平台CUDA支持,同时推出了标准化性能对比工具lemonadebench,并加入了LMX-Omni模型支持与实时监控端点等功能。
史上首次 AMD Lemonade SDK支持NVIDIA CUDA
作者:技术拾光
时间:2026-06-12
浏览:398
文章目录
AMD主导的开源AI服务器Lemonade 10.7正式集成NVIDIA CUDA后端
6月11日消息,AMD主推的开源本地AI服务器项目Lemonade,日前发布10.7版本。该版本最引人注目的变化并非对自身产品的进一步优化,而是正式集成了NVIDIA CUDA后端。这意味着,AMD主导的开源方案首次完整支持NVIDIA GPU的本地AI推理。
此前硬件生态已覆盖多平台,唯独缺少NVIDIA支持
Lemonade之前已覆盖相当广泛的硬件生态:AMD自家的Ryzen AI NPU、Radeon和Instinct系列GPU、x86_64架构的CPU,甚至Apple Metal GPU均在其支持列表内。然而,唯独缺少NVIDIA这一块。对许多开发者而言,这多少有些遗憾——NVIDIA GPU在AI推理场景中的地位众所周知。如今,这个缺口终于被补上。
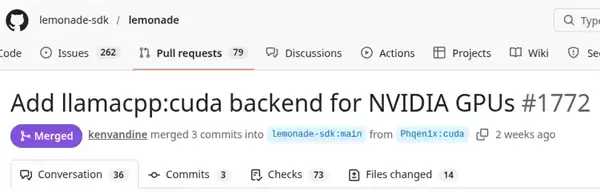
10.7版本实现双平台CUDA集成,新增GPU检测功能
具体到10.7版本,它在Windows和Linux双平台上同步集成了Llama.cpp的CUDA后端,同时还新增了NVIDIA GPU检测功能。这意味着,只要机器上搭载NVIDIA显卡,无需额外配置,即可获得与AMD硬件几乎一致的本地AI体验。换言之,Lemonade终于开始真正实现“跨厂商”支持。
Linux平台新增stable-diffinition.cpp CUDA后端及Vulkan扩展
此外,Linux平台上首次加入了stable-diffinition.cpp的CUDA后端,同时引入了跨厂商的Vulkan扩展支持。这一系列举措将GPU适配范围进一步向前推进。可以说,从即日起,使用Lemonade搭建本地AI方案时,硬件选择基本不再存在门槛。
新增lemonade bench工具,标准化LLM性能对比
本次更新还包含一个值得留意的工具——lemonade bench。它是Lemonade产品路线图中的重要一环,专门用于在Llama.cpp、FastFlowLM、vLLM、Ryzen AI等多个后端之间进行端到端的LLM推理性能对比。对开发者而言,该工具的意义显而易见:此前若想对比不同后端的实际表现,往往需要自行拼凑测试流程;如今Lemonade将这一流程标准化,大幅降低了测试门槛。
同步上线LMX-Omni模型支持与Prometheus实时监控端点
除此之外,LMX-Omni模型支持和原生Prometheus实时监控端点等功能也一并上线。尽管这些功能听起来不像CUDA支持那样“炸裂”,但它们共同指向一个方向:Lemonade正在稳步推进,向一个真正覆盖全场景的本地AI引擎演进。
外部开发者贡献CUDA后端,AMD团队合并主线
最后,有一个细节值得注意:本次CUDA后端的合并最初由外部开发者提交,最终由AMD团队合并至主线。换个角度看待,这不仅是技术层面的补齐,更是一种姿态——AMD愿意在开放生态中接纳竞争对手的硬件,让开发者拥有更多选择。从行业视角来看,这或许是本次更新中最有意思的信号:跨厂商协作正在从口号变为现实。
Lemonade 10.7现已开源,欢迎下载体验
目前Lemonade 10.7版本已可通过项目主页直接下载体验,所有代码开源在GitHub上。如果你恰好手头同时拥有AMD和NVIDIA设备,不妨实际运行一遍lemonade bench,观察不同后端组合下的推理性能差异。毕竟,数据才是最直观的答案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章