

DETR是一种基于Transformer的目标检测模型,无需预设计锚框和非极大值抑制后处理。它通过卷积神经网络提取特征,经Transformer编码器-解码器结构固定输出100个预测结果,采用二分图匹配算法实现预测框与真实框的一对一最优匹配,联合分类损失和回归损失优化模型,实现端到端检测。
大白话解读DETR模型
作者:技术拾光
时间:2026-05-31
浏览:605
文章目录
简单的介绍
DETR,全称为DEtection TRansformer,中文可称作“检测变换器”。
从字面拆解来看:DET代表目标检测,R指代著名的Transformer架构。两者结合,构成了一个专门用于目标检测任务的Transformer模型。
传统的YOLO系列算法包含多个依赖人工设计的环节,其中最典型的便是需要手动预设锚框。此外,模型完成推理后,会产生大量冗余的预测框,必须借助非极大值抑制(NMS)算法来筛选和剔除重复框,才能保留最优结果。DETR模型的提出,正是为了从根本上解决这些繁琐的人工操作和后续处理步骤。
下面,我们逐步解析DETR的整体工作流程:
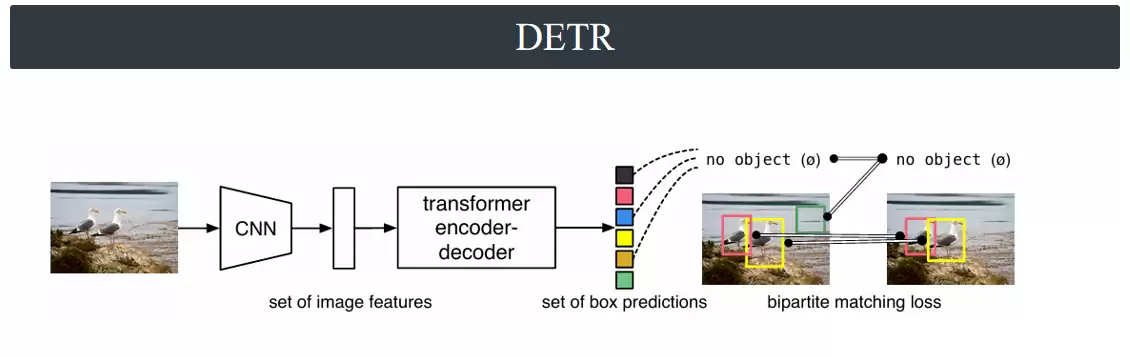
首先,一张图像被送入卷积骨干网络,用于提取图像的深层特征信息。随后,DETR将提取到的特征图展平,并送入一个完整的Transformer模型——该模型同时包含编码器和解码器结构。
Transformer最终会固定输出100组预测结果,对应100个目标“查询”。每组结果包含两部分关键信息:目标的类别,以及预测框的坐标。
由于一张图像中通常不会恰好有100个物体,因此对于未匹配到真实目标的预测框,DETR会统一标记为“无目标”类别;而有效目标的预测框,则会映射回原图,与数据集中的真实标注框进行比较。
在训练阶段,DETR采用“二分图匹配”的方式,对预测框和真实框进行一对一匹配,并计算专属的匹配损失。通过反向传播不断优化模型参数,逐步缩小预测框与真实框之间的坐标误差和分类误差,使检测结果愈发精准。
到了推理阶段,流程更加简洁:模型无需锚框,也无需非极大值抑制(NMS)等后处理步骤,直接输出有效目标的边界框坐标和对应类别,一步到位,完成端到端的目标检测。
二分图匹配损失
设想一个场景:现有3名司机和3名乘客,需要进行合理的匹配调度,目标是使整体出行成本最低。为此,可以构建一个成本矩阵,直观展示每位司机接送每位乘客对应的单独成本,以此作为最优调度的计算依据。
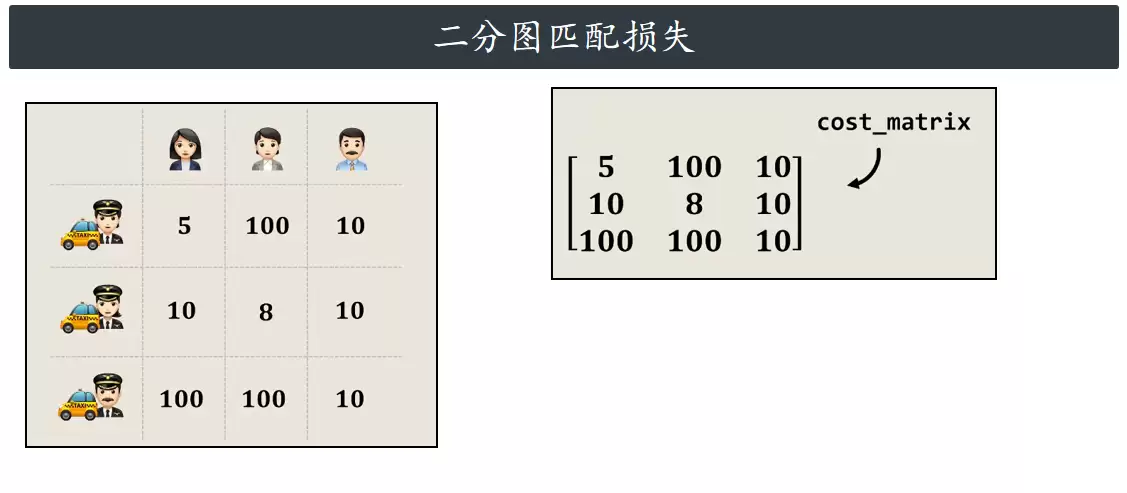
事实上,DETR中预测框与真实框的匹配逻辑,与上述司机-乘客调度原理完全一致。
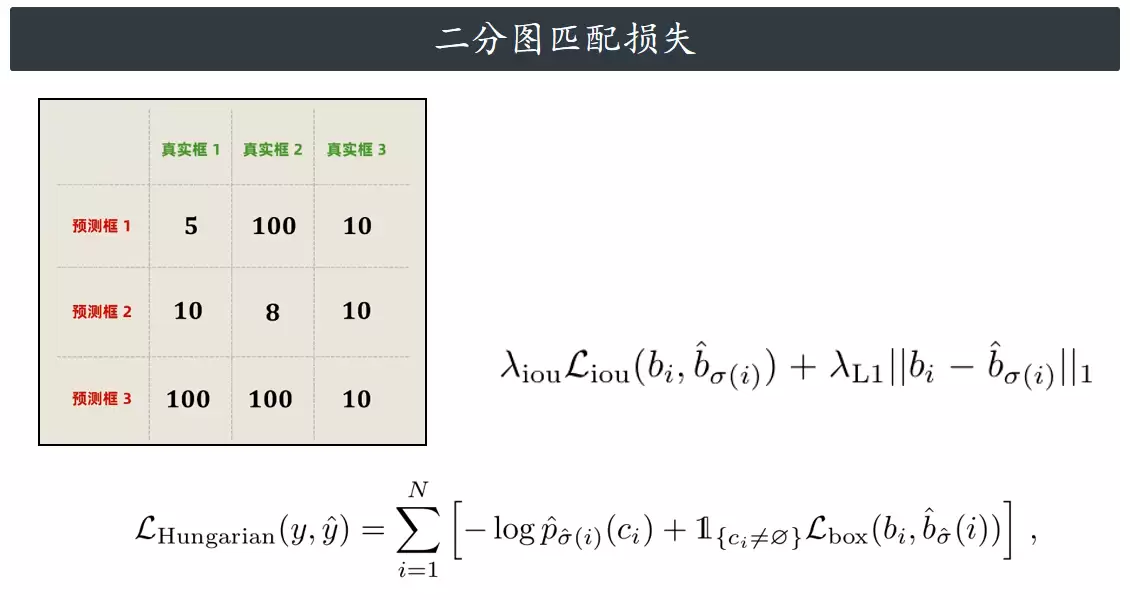
我们可以构建一个损失矩阵,矩阵中的每个数值代表单个预测框与单个真实框之间的匹配损失。然后,通过二分图匹配算法,自动计算哪个预测框与哪个真实框契合度最高、整体损失最小,直接完成一对一的最优配对。正是依靠这种全局最优的匹配方式,DETR无需再进行非极大值抑制(NMS)来筛选重复框,省去了后续处理步骤。
DETR默认设置固定数量N=100,即固定生成100个预测框。模型假设一张图像中的目标物体数量不会超过100个,这足以覆盖绝大多数检测场景。
二分图匹配的核心作用在于确定:第i个真实目标,应当对应匹配哪一个预测框。
整体损失函数主要由分类损失和回归损失两部分组成:
第一部分是分类损失。假设真实物体为猫,模型需要使猫这一类别的预测概率尽可能接近1;损失计算时会对概率取负值,概率越高、预测越准,分类损失就越小。同时,还会加入一个指示函数:只有当真实目标不是背景、是有效物体时,才会计算分类损失,背景类不参与损失计算。
第二部分是边界框回归损失,用于约束预测框的位置和大小。
回归损失又分为两项:
- 一是绝对值误差,主要衡量预测框中心点的偏移距离,用于修正框的位置偏差;
- 二是交并比误差,用于约束两个框的重合程度,保证预测框与真实框的面积、范围尽量贴合。
DETR依靠二分图匹配完成框的一对一分配,再将分类损失与回归损失联合优化,既保证了物体类别的预测准确,又能使检测框的位置、尺寸精准贴合真实目标。
模型架构
首先介绍骨干网络部分:将一张图像输入卷积神经网络(CNN),目的是提取图像的特征。提取特征后,需与位置编码进行加法运算,使模型能够感知图像中各像素的位置关系,随后将加和结果传递给Transformer模型。
位置编码有两种方式,与大家熟悉的操作一致:第一种是正弦余弦编码,与原始Transformer完全相同,简单来说,就是用正弦标记图像像素的横坐标位置,用余弦标记纵坐标位置,固定不变;第二种是可学习的位置编码,无需复杂操作,仅需初始化一个位置编码矩阵,模型在训练过程中自行优化调整。
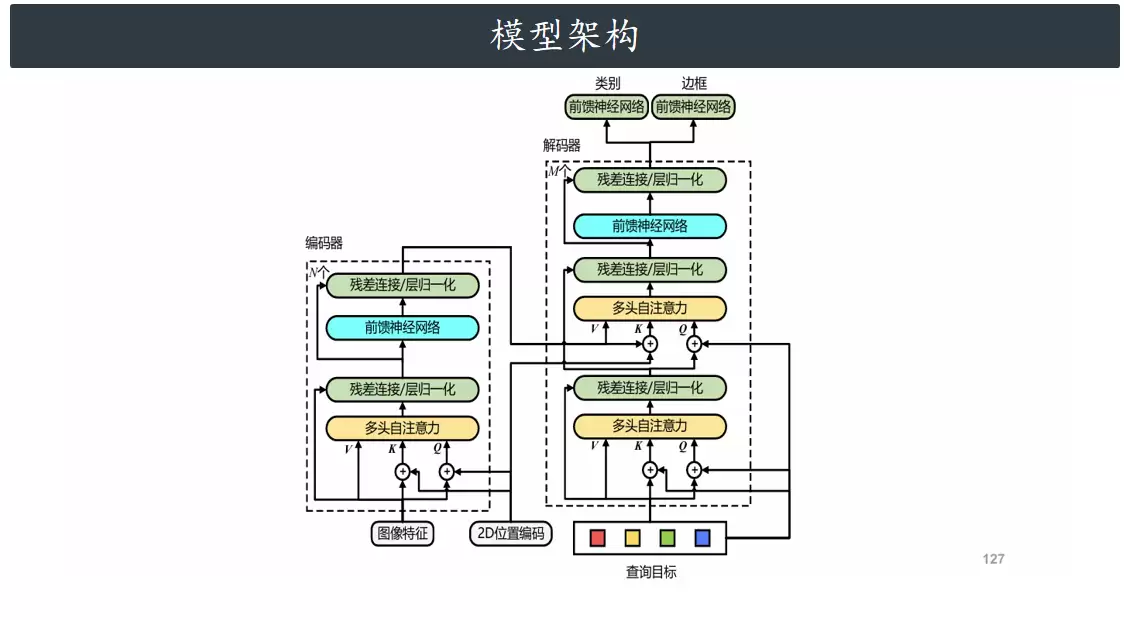
接下来介绍Transformer模型,它分为编码器和解码器两部分。编码器使用卷积神经网络提取的特征,核心作用是在这些特征之间进行注意力计算,使不同位置的特征建立关联。例如,图像中有一头牛,编码器能让“牛头”与“牛尾”的特征产生联系,从而使模型能够识别出一头完整的牛,而非零散的部位。
编码器处理完毕后,将结果传递给解码器。解码器的核心作用是利用编码器学到的特征相关性,将图像中的物体组合识别出来,并画出对应的预测框。这里需要提及“目标查询”(Object Query,简称OQ)——它相当于向解码器“提问”的角色。例如,它会问解码器:“这张图像中是否有人形物体?”“图像右下角有没有圆形物体?”OQ初始为一个全零张量,待解码器训练完成后,其输出会传递给前馈神经网络(即检测头),每个前馈神经网络专门负责预测一个物体,最后模型将预测出的边界框绘制在原始图像上。
为便于理解,我们结合具体的张量尺寸来梳理流程(无需记忆复杂细节,理解整体过程即可):
假设输入图像为(3, 800, 1066)大小的张量(3为图像通道数,800和1066为图像的高和宽)。经过卷积神经网络处理后,图像的长和宽均缩小至原来的1/32,变为(2048, 25, 34)大小的张量(2048为特征通道数,25和34为缩小后的高和宽)。
随后,该张量经过一个2D卷积层,将特征通道数从2048压缩至256,变为(256, 25, 34)的张量;接着与同样为(256, 25, 34)大小的位置编码进行加法运算,融合特征与位置信息。
之后,融合后的张量被变形为(850, 256)大小的张量,并传递给Transformer编码器——这里的850即为25×34(缩小后的高×宽),可理解为“编码长度”,256为每个特征token的嵌入维度。编码器处理完毕后,张量形状不变,仍为(850, 256),直接传递给解码器的交叉注意力层。
解码器的输入是一个(100, 256)大小的张量,100对应前述的100个预测框(模型默认一张图像最多100个物体),256仍为token的嵌入维度。解码器处理完毕后,输出形状仍为(100, 256),再传递给前馈神经网络(检测头)。
最后,检测头输出两个结果:一个是1×91的类别预测值(91代表所有可能的物体类别,包括背景),另一个是1×4的预测框坐标(对应预测框的位置和大小)。
此处补充一个与前述“司机-乘客调度”一致的逻辑:可以构建一个矩阵,行对应100个预测框,列对应图像中的真实物体,矩阵中的每个数值代表“第i个预测框匹配第j个真实物体”的总损失(包含分类损失和回归损失)。通过二分图匹配算法,找到使整体损失最小的一对一匹配方式,直接确定每个真实物体对应的最优预测框,从而无需再进行NMS处理。
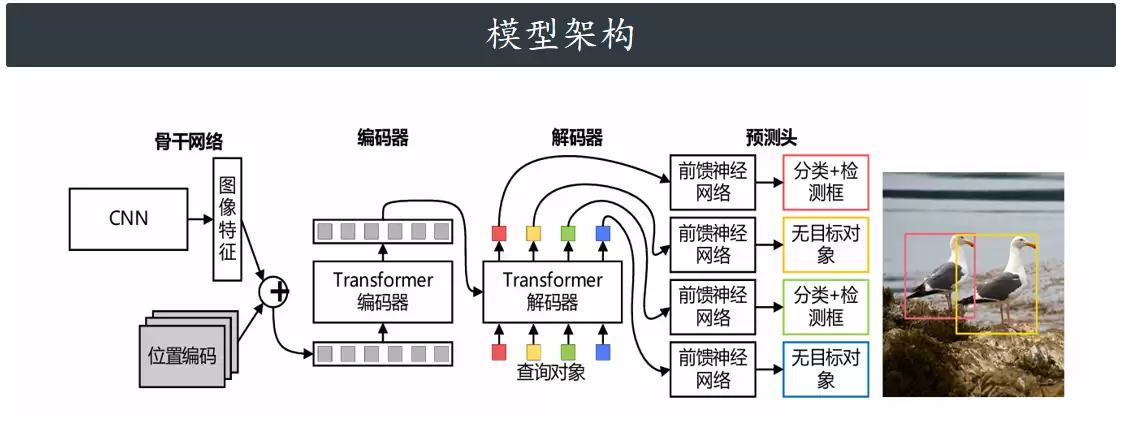
预测头包含两个并行的小网络:一个负责预测物体的类别,另一个负责预测边界框的坐标,两者独立输出,最后合并为最终的检测结果。
同时,目标查询(Object Query)是一组可学习的张量,是解码器的输入,而非编码器的输出。可以将其理解为解码器提前准备好的一批“问题”——例如“图像中是否有物体?在哪里?是什么?”——解码器带着这些问题去查询编码器提炼出的图像特征。OQ的初始值为零,但它附带一个可学习的位置编码,用于区分不同的查询槽位。
在位置编码方面:编码器中,每一层的自注意力计算中,位置编码都会加到K和Q上;在解码器中,每一层交叉注意力的K(来自编码器的输出)也会加上对应的位置编码,而OQ本身则扮演了解码器Q的位置编码角色。此外,这种加法在编码器和解码器的每一层都会重复执行,各执行6次。
解码器的每一层并非从零开始,而是将上一层输出的预测结果(物体的类别和位置)以残差连接的形式传入下一层,相当于“带着上一轮的结论继续优化”。这样做的好处是,预测结果可以在每一层被逐步精细化。
举例说明:第一层解码器可能只能模糊地感知到“图像中有个人”;到了第二层,结合更多上下文信息,发现“这个人站在画面右侧”;到了第三层,进一步细化,识别出“这个人正在举着双手”。每一层都在前一层的基础上向前推进一步,最终得到更准确的检测结果。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。