

用户利用二手硬件在单GPU工作站成功运行万亿参数大模型,配置包括至强处理器和768GB混合内存,其中傲腾内存突破显存瓶颈。通过llama.cpp实现GPU与CPU混合推理,模型参数存储于傲腾内存,计算由两张RTX3060显卡完成。该低成本方案展示了利用傲腾等内存扩展技术运行大模型的潜力。
英特尔傲腾内存运行万亿参数AI大模型
作者:技术拾光
时间:2026-05-25
浏览:560
文章目录
近日,Reddit用户APFrisco分享了一项硬核技术方案。他利用二手硬件,在一台单GPU工作站上成功运行了参数规模达1万亿的Kimi K2.5大模型,推理速度约为每秒4个Token。这一成果令人瞩目,因为万亿参数模型通常需要大规模计算集群才能支持。
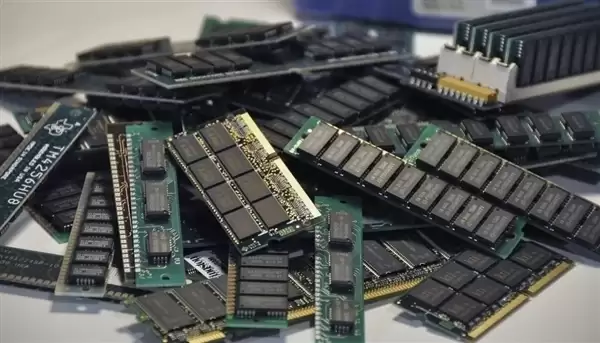
那么,这套配置是如何搭建的呢?其核心硬件配置明确:处理器采用英特尔至强金牌6246,主板为泰安S5630GMRE-CGN。系统的突出亮点在于内存——总容量高达768GB。这并非普通内存组合,它由两部分构成:6条32GB的三星DDR4-2666 ECC内存条,以及6条128GB的英特尔傲腾DCPMM持久内存模块。正是后者,成为了突破显存限制的关键。
图形计算依靠两张华硕GeForce RTX 3060 OC 12GB显卡实现。存储使用了一块西部数据WD SN850X 2TB固态硬盘,电源则选用了华擎Steel Legend SL-850G 850W全模组电源。整套配置体现了鲜明的极客“混搭”风格,其核心思路是借助相对廉价的消费级或二手硬件,来完成专业级的计算任务。
软件策略:混合推理破解显存瓶颈
硬件组合是基础,真正的突破在于软件方案。该方案采用了基于llama.cpp的GPU与CPU混合推理技术。具体而言,通过llama.cpp的override-tensor标志,系统将模型中的路由组件强制调度至两张总计24GB显存的GPU中进行处理。而模型那万亿规模的庞大参数,则全部交由傲腾内存负责存储与读取。
这一策略的精妙之处在于,它精准规避了单卡显存不足这一主要障碍。GPU专注于其擅长的计算密集型任务,而参数存储与调度的沉重负担,则交给了容量巨大且速度远超传统固态硬盘的傲腾内存。通过这种协同分工,使得在有限资源下运行超大规模模型成为可能。
傲腾技术的价值与未来展望
值得提及的是英特尔傲腾技术。尽管该产品线已停产,但其独特的性能定位——介于DRAM内存与固态硬盘之间——使其在特定应用场景中仍具价值。对于此类需要超大内存容量但预算有限的项目而言,二手傲腾模块成为了替代昂贵大容量DRAM的一种特殊选择。
这一案例也揭示了未来的技术方向。随着CXL(Compute Express Link)计算快速连接标准的逐步成熟,业界预期未来将出现更多高性价比、可字节寻址的内存扩展解决方案。大语言模型对内存容量的需求近乎无限,此类技术的进步将为更普惠的AI算力基础设施开辟道路。从这个角度看,此次极客实验不仅是一次硬件改造,也像是对未来技术路径的一次前瞻性演示。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。