

本文为墨天轮数据库管理服务团队第219期技术分享,内容原创,作者为技术顾问孙文龙,如需转载请联系小墨(VX:modb666)并注明来源。如需查看更多文章可关注【墨天轮】公众号。1. MySQL MVCC 原理与实现方式1.1 MVCC 基本概念MVCC(Multi-Version Concurren
MySQL MVCC多版本并发控制原理、实现与对比分析
作者:技术拾光
时间:2026-08-14
浏览:582
文章目录
本文为墨天轮数据库管理服务团队第219期技术分享,内容原创,作者为技术顾问孙文龙,如需转载请联系小墨(VX:modb666)并注明来源。如需查看更多文章可关注【墨天轮】公众号。
1. MySQL MVCC 原理与实现方式
1.1 MVCC 基本概念
MVCC(Multi-Version Concurrency Control,多版本并发控制) 是一种数据库并发控制技术,通过在系统中维护数据的多个版本,使得读操作不会阻塞写操作,写操作也不会阻塞读操作,从而显著提高数据库的并发性能。
1.2 MySQL InnoDB 的 MVCC 实现
1.2.1 核心数据结构
-- 隐藏字段(每行记录包含)
DB_TRX_ID    -- 最近修改的事务ID(6字节)
DB_ROLL_PTR  -- 回滚指针,指向Undo Log(7字节)
DB_ROW_ID    -- 行ID(6字节,当没有主键时自动生成)
-- 隐藏字段(每行记录包含)
DB_TRX_ID    -- 最近修改的事务ID(6字节)
DB_ROLL_PTR  -- 回滚指针,指向Undo Log(7字节)
DB_ROW_ID    -- 行ID(6字节,当没有主键时自动生成)
1.2.2 Undo Log(回滚日志)
Undo Log 是 MVCC 的核心组件,存储数据修改前的旧版本:
- Insert Undo Log:记录INSERT操作,用于事务回滚时删除
- Update Undo Log:记录UPDATE/DELETE操作,用于事务回滚和MVCC读视图
1.2.3 Read View(读视图)
Read View 定义了事务在某一时刻能看到的数据版本:
class ReadView:
    m_ids: list          # 活跃事务ID列表
    min_trx_id: int      # 最小活跃事务ID
    max_trx_id: int      # 最大活跃事务ID
    creator_trx_id: int  # 创建Read View的事务ID
1.2.4 版本链(Version Chain)
当前行记录 (DB_TRX_ID=200, DB_ROLL_PTR→)
        ↓
Undo Log v1 (DB_TRX_ID=150, DB_ROLL_PTR→)
        ↓
Undo Log v2 (DB_TRX_ID=100, DB_ROLL_PTR=null)
1.3 MVCC 可见性判断规则
对于每行记录,判断是否对当前事务可见:
- DB_TRX_ID < min_trx_id:事务已提交,可见
- DB_TRX_ID >= max_trx_id:事务未开始,不可见
- min_trx_id ≤ DB_TRX_ID < max_trx_id:
*   如果 DB_TRX_ID 在 m_ids 中:事务活跃,不可见
    *   如果 DB_TRX_ID 不在 m_ids 中:事务已提交,可见
1.4 隔离级别与 MVCC
2.MySQL 是否会产生类似 Oracle ORA-01555 的快照过旧问题?
2.1 Oracle ORA-01555 问题原理
Oracle 的 ORA-01555 “snapshot too old” 错误发生在:
- 长事务需要读取一致性快照
- 所需的 Undo 数据已被覆盖(Undo 表空间不足或 Undo 保留时间过短)
- 无法重建一致性读视图
2.2 MySQL 的差异与优势
2.2.1 Undo Log 管理机制不同
-- MySQL InnoDB Undo 配置
SHOW VARIABLES LIKE'innodb_undo%';
/*
innodb_undo_directory      -- Undo文件存储路径
innodb_undo_tablespaces    -- Undo表空间数量
innodb_undo_log_truncate   -- 自动截断Undo Log
innodb_undo_logs           -- Undo Log数量
*/
2.2.2 MySQL 不会产生 ORA-01555 的原因
MySQL InnoDB 能够规避 ORA-01555 快照过旧问题的核心原因在于其Purge 机制与 Read View 的协作设计:
- (1)Purge 线程的保守清理策略
MySQL 的 Purge 线程不会立即清理已提交的 Undo Log,而是采用严格的安全检查:
// InnoDB Purge 核心逻辑(简化)
bool can_purge(trx_id) {
   // 获取当前所有活跃事务的最小 ID
   min_active_trx_id = get_min_active_trx_id();
   // 只有当 undo 记录的 trx_id 小于所有活跃事务的 min_trx_id 时才能 purge
   // 这确保了长事务需要的所有历史版本都不会被清理
   return trx_id < min_active_trx_id;
}
关键点:Purge 会计算 active_trx_min_id(当前所有活跃事务的最小 ID),只有当 Undo 记录的 DB_TRX_ID 小于这个值时,才会被标记为可清理。
- (2)Read View 与事务生命周期绑定
特性|Oracle|MySQL InnoDB
|-|-|-|
快照获取时机|每次 SELECT 语句开始时|事务开始时创建 Read View
快照基准|SCN (System Change Number)|活跃事务 ID 列表 (m_ids)
快照有效期|语句级别|事务级别
MySQL 的设计更加保守:只要事务还在运行,其 Read View 就一直有效,对应的历史版本就不能被 Purge。
- (3)长事务的保护机制
-- 即使存在长事务,MySQL 也不会丢失历史版本
-- 场景说明:
-- 事务 A (trx_id=100) 开启了 REPEATABLE READ
-- 事务 B (trx_id=101) 在事务 A 运行期间修改了数据并提交
-- 事务 A 仍然可以看到 trx_id=101 提交前的数据
-- 原因:事务 A 的 Read View 中 m_ids=[101, ...],101 在活跃列表中
--      因此 101 修改的旧版本对事务 A 可见
-- 并且该旧版本不会被 Purge,因为 101 仍在 m_ids 中- (4)Undo Log 的分段管理
MySQL 的 Undo Log 按 rseg(Rollback Segment)管理,每个表空间可以配置多个 Undo 页面:
-- 配置建议
SETGLOBAL innodb_undo_tablespaces =4;  -- 多个表空间分散IO
SETGLOBAL innodb_undo_log_truncate =ON; -- 启用自动截断
SETGLOBAL innodb_max_undo_log_size =1GB; -- 单个Undo文件最大1G- (5)与 Oracle 的本质差异
Oracle 快照过旧流程:
1. SELECT 启动 → 获取当前 SCN
2. 需要读取 undo 中 SCN=T1 的旧版本
3. 但该 undo 已被覆盖(Retention 策略或空间不足)
4. → ORA-01555 错误
MySQL 规避流程:
1. 事务启动 → 创建 Read View,记录活跃事务列表 [100, 101, 102]
2. 需要读取 trx_id=50 的旧版本
3. Purge 线程检查:50 < min([100,101,102])=100? 是,可以清理
4. 但如果 50 是长事务需要读取的版本呢? → 检查 Read View
5. 该旧版本仍然保留,因为可能对活跃事务可见
6. → 不会出现"找不到历史版本"的问题
总结:MySQL 通过 “活跃事务列表 + min_trx_id 门限” 的双重保护,确保长事务需要的历史版本永远不会被 Purge 清理,从根本上避免了 ORA-01555 问题。
2.2.3 可能出现的类似问题
虽然 MySQL 没有 ORA-01555,但在极端情况下可能出现:
-- 长事务导致的问题
ERROR 1205 (HY000): Lock wait timeout exceeded
-- 或
ERROR 1213 (40001): Deadlock found
3.MySQL MVCC 是否会产生类似 PostgreSQL 的数据膨胀问题?
3.1 PostgreSQL 数据膨胀问题
PostgreSQL 的 MVCC 实现特点:
- 多版本存储在主表:每个新版本都在原表中存储新行需要
- VACUUM 清理:依赖 VACUUM 回收死元组空间
- HOT(Heap Only Tuple)优化:减少索引更新,但仍有膨胀
3.2 MySQL InnoDB 的差异
3.2.1 存储架构优势
MySQL InnoDB 存储结构:
表空间 (.ibd文件)
├── 聚簇索引 (主键索引)
│   ├── 行数据 (包含隐藏字段)
│   └── 版本链指针
└── 二级索引
    └── 主键引用
3.2.2 不会产生严重数据膨胀的原因
- Undo Log 分离存储:旧版本存储在 Undo Log 中,不在主表中
- Purge 线程自动清理:后台线程自动清理不再需要的 Undo Log
- 版本链回溯机制:通过指针回溯,不复制整行数据
- 页内空间复用:删除的记录空间可以被新记录复用
3.2.3 可能的空间问题
-- 检查表空间使用情况
SELECT
    TABLE_SCHEMA,
    TABLE_NAME,
    DATA_LENGTH/1024/1024AS data_mb,
    INDEX_LENGTH/1024/1024AS index_mb,
    DATA_FREE/1024/1024AS free_mb
FROM information_schema.TABLES
WHERE TABLE_SCHEMA NOTIN ('mysql', 'information_schema', 'performance_schema')
ORDERBY DATA_LENGTH DESC LIMIT 10;
3.3 性能对比
4.MySQL 的 Undo 空间限制机制与长事务影响
4.1 Undo 表空间的配置限制
MySQL 通过明确的配置参数控制 Undo 表空间的大小:
-- 查看当前 Undo 配置
SHOW VARIABLES LIKE'innodb_max_undo_log_size';   -- 单个 Undo 表空间最大大小(默认 1GB,可动态调整)
SHOW VARIABLES LIKE'innodb_undo_tablespaces';    -- Undo 表空间数量(默认 2,范围 2-127,可动态调整)
SHOW VARIABLES LIKE'innodb_undo_log_truncate';   -- 是否自动截断(默认 ON,可动态调整)
SHOW VARIABLES LIKE'innodb_undo_directory';      -- Undo 文件存储路径
关键配置说明:
- innodb_max_undo_log_size:硬性限制,当单个 Undo 文件达到此大小时触发限制
- innodb_undo_tablespaces:允许多个 Undo 文件循环使用
- innodb_undo_log_truncate:启用后自动回收空闲 Undo 空间
4.2 长事务是否会导致 Undo 无限制增长?
4.2.1 理论上的持续增长
是的,在长事务运行期间,Undo Log 会持续增长,因为:
- 长事务的 Read View 要求所有更早版本必须保留
- 只要事务还在运行,Purge 线程就不能清理它需要的旧版本
- 在此期间的所有修改都会产生新的 Undo 记录
4.2.2 实际中的限制机制
但 MySQL 通过以下机制防止真正的"无限"增长:
- (1)空间切换机制
# Undo 空间管理简化逻辑
def handle_undo_space():
    if current_undo_file.is_full():
        if has_a vailable_undo_tablespace():
            # 切换到下一个可用的 Undo 表空间
            switch_to_next_undo_tablespace()
        else:
            # 所有表空间都满了,需要等待 Purge
            if purge_thread.can_catch_up():
                wait_for_purge_completion()
            else:
                # 长事务阻塞了 Purge,事务将阻塞
new_transaction.wait()- (3)事务阻塞场景
当所有 Undo 表空间都达到 innodb_max_undo_log_size 且长事务阻塞了 Purge 时:
- 新事务会被阻塞,等待 Undo 空间释放, 报错Error 3871: Undo tablespace is full或 Error 1114: The table is full
- 系统继续运行,但吞吐量下降
- 不会破坏数据一致性,这是与 Oracle ORA-01555 的关键区别
- (3)InnoDB 内部限制
- 每个 Undo 表空间最多 128 个 Rollback Segment
- 每个 Rollback Segment 有固定数量的 Undo Slot
- 物理磁盘空间是最终限制
4.3 Undo 空间增长对数据库性能的影响
与 PostgreSQL 的数据膨胀主要影响存储空间和查询性能不同,MySQL Undo 空间的增长主要通过以下机制影响数据库性能:
4.3.1 I/O 性能影响
Undo Log 读/写开销
- 版本链回溯开销:长版本链需要在 Undo 中多次回溯,增加读取延迟
- Purge 扫描成本:需要扫描更长的 Undo Log 链来决定哪些可以清理
- 磁盘空间压力:大量的 Undo 数据可能挤出 Buffer Pool 中的热数据
4.3.2 CPU 和内存影响
(1)Purge 线程 CPU 消耗
-- 监控 Purge 线程状态
SHOW ENGINE INNODB STATUSG
-- 查看 Purge 相关部分:
-- "BACKGROUND THREAD" -> "srv_purge_thread"
-- "History list length" 表示待清理的记录数
Purge 延迟的连锁反应:
大事务 → Undo 快速增长 → History List 增长 →
Purge 线程忙不过来 → 更多 Undo 堆积 →
Purge 线程更忙(恶性循环)
(2)Buffer Pool 竞争
# 简化版 Buffer Pool 竞争模型
Total_Memory = Buffer_Pool_Size + Undo_Buffer_Size
# 如果 Undo 占用过多内存(通过文件系统缓存),
# Buffer Pool 中的热数据可能被换出到磁盘
4.3.3 事务性能影响
(1)事务启动延迟
# 事务启动时的额外开销
def start_transaction():
    # 1. 创建 Read View
    read_view = create_read_view()
    # 2. 如果 Undo 很大,需要更多时间来扫描活跃事务
    # 活跃事务越多,扫描时间越长
    scan_active_transactions()
    # 3. 版本链指针初始化
    init_version_chain_pointers()
(2)查询性能下降
-- 版本链遍历示例
-- 当版本链很长时,即使简单的查询也可能变慢
EXPLAIN SELECT*FROM users WHERE id =100;
-- 实际执行时可能需要遍历:
-- 当前版本 (trx_id=200) -> Undo v1 (trx_id=150) ->
-- Undo v2 (trx_id=100) -> Undo v3 (trx_id=50) -> ...
4.3.4 性能监控矩阵
4.3.5 性能优化策略
(1)配置优化
# my.cnf 性能优化配置
[mysqld]
# Undo 性能优化
innodb_purge_threads = 4          # 增加 Purge 线程数
innodb_purge_batch_size = 300     # 增大批次大小
innodb_max_purge_lag = 100000     # 设置 Purge 滞后阈值
innodb_max_purge_lag_delay = 5000 # 最大延迟毫秒数
# I/O 优化
innodb_flush_log_at_trx_commit = 2  # 平衡性能与持久性
innodb_flush_method = O_DIRECT      # 直接 I/O,减少 OS 缓存
innodb_io_capacity = 2000          # 提高 IO 能力
innodb_io_capacity_max = 4000
(2)架构优化
-- 1. 读写分离,减少主库长查询
-- 2. 分库分表,分散 Undo 压力
-- 3. 使用缓存层,减少数据库直接访问
-- 4. 大事务拆分为小事务
-- 示例:大事务拆分
-- 不推荐:
START TRANSACTION;
UPDATE large_table SET status ='processed'WHERE created_at <'2026-01-01';
COMMIT;
-- 推荐:
SET autocommit =0;
UPDATE large_table SET status ='processed'WHERE created_at <'2026-01-01' LIMIT 1000;
COMMIT;
UPDATE large_table SET status ='processed'WHERE created_at <'2026-01-01' LIMIT 1000;
COMMIT;
-- ... 循环直到完成
(3)查询优化
-- 使用覆盖索引减少回表
-- 版本链回溯时,如果只需要索引列,可以减少 Undo 访问
CREATE INDEX idx_covering ON users (id, name, email);
-- 查询时明确指定需要的列
SELECT id, name FROM users WHERE id =100;  -- 优于 SELECT *
-- 避免在长事务中进行范围查询
-- 范围查询可能锁定大量行,产生大量 Undo
4.3.6 与 PostgreSQL 数据膨胀的性能对比
4.4 Undo 表空间满了的连锁反应
4.4.1 标准处理流程
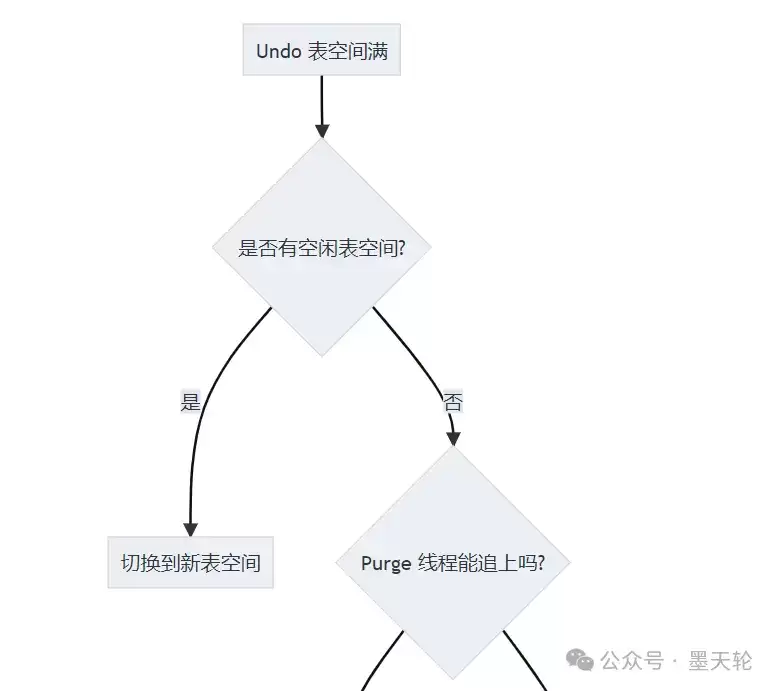
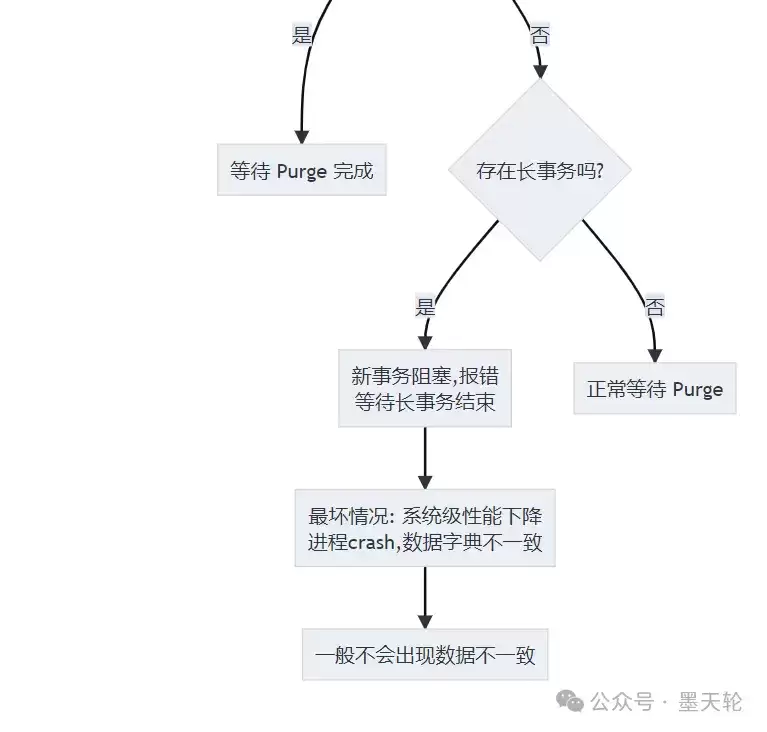
4.4.2 几个数据库的对比
5. MySQL MVCC 的优缺点与最佳实践
5.1 优点
- 数据一致性优先:宁可阻塞事务,也不破坏快照一致性
- 配置简单直观:空间限制比时间限制更容易理解和配置
- 可预测的行为:达到上限后的行为相对可预测
- 自动管理:Purge 线程和自动截断减少人工干预
5.2 缺点
- 可能导致系统性阻塞:长事务会影响整个系统
- 需要足够的磁盘空间:需要预分配足够的 Undo 空间
- 运维监控要求高:需要主动监控长事务和 Undo 使用率
- 版本链遍历:长版本链可能影响读性能
- Purge 延迟:大量更新可能导致 Purge 滞后
5.3 核心结论:
- MySQL 的 Undo 机制确实会导致 Undo 随着长事务增长
- 但有明确的配置上限,不会真正无限制增长
- 达到上限后表现为系统性能下降而非数据不一致
- 这是“可用性 vs 一致性”的设计取舍,MySQL 选择了一致性优先
5.4 最佳实践
5.4.1 配置优化
# my.cnf 推荐配置
[mysqld]
# Undo 空间配置(根据磁盘空间调整)
innodb_max_undo_log_size = 4G          # 单个 Undo 文件最大 4GB
innodb_undo_tablespaces = 8            # 8 个 Undo 表空间循环使用
innodb_undo_log_truncate = ON          # 启用自动截断
innodb_purge_rseg_truncate_frequency = 64  # 更频繁的回收
# 事务超时控制
innodb_lock_wait_timeout = 30          # 锁等待超时 30 秒
innodb_rollback_on_timeout = ON        # 超时自动回滚
# 监控优化
performance_schema = ON
innodb_monitor_enable = all
5.4.2 监控脚本
-- 监控MVCC相关指标
SELECT
'当前事务数'AS metric,
COUNT(*) ASvalue
FROM information_schema.INNODB_TRX
UNIONALL
SELECT
'长事务数(>60s)',
COUNT(*)
FROM information_schema.INNODB_TRX
WHERE TIME_TO_SEC(TIMEDIFF(NOW(), trx_started)) >60
UNIONALL
SELECT
'Undo Log大小(MB)',
    ROUND(SUM(size)/1024/1024, 2)
FROM information_schema.INNODB_TABLESPACES
WHERE name LIKE'%undo%';
-- 自动检测和处理长事务
DELIMITER //
CREATE PROCEDURE monitor_and_handle_long_transactions()
BEGIN
    DECLARE v_count INT;
    -- 检测超时事务
    SELECT COUNT(*) INTO v_count
    FROM information_schema.INNODB_TRX
    WHERE TIME_TO_SEC(TIMEDIFF(NOW(), trx_started)) > 600; -- 10分钟
    IF v_count > 0 THEN
        -- 记录到日志表
        INSERT INTO sys.long_transaction_alert
        (alert_time, long_transaction_count, details)
        SELECT
            NOW(),
            COUNT(*),
            GROUP_CONCAT(CONCAT('TRX:', trx_id, ' User:', trx_mysql_thread_id))
        FROM information_schema.INNODB_TRX
        WHERE TIME_TO_SEC(TIMEDIFF(NOW(), trx_started)) > 600;
        -- 这里可以扩展:发送告警、尝试安全终止等操作
        -- 注意:在生产环境中终止事务需要非常谨慎
    END IF;
END//
DELIMITER ;
-- 创建调度任务
CREATE EVENT check_undo_and_transactions
ON SCHEDULE EVERY 5 MINUTE
DO CALL monitor_and_handle_long_transactions();
-- 监控 Undo 空间使用情况
SELECT
    ROUND(SUM(TOTAL_EXTENTS*EXTENT_SIZE)/1024/1024, 2) AS total_mb,
    round(sum(TOTAL_EXTENTS*EXTENT_SIZE-FREE_EXTENTS*EXTENT_SIZE)/1024/1024, 2) AS used_mb,
    ROUND(SUM(TOTAL_EXTENTS - FREE_EXTENTS) * 100 / SUM(TOTAL_EXTENTS), 2) AS used_percent,
    COUNT(*) AS num_tablespaces
FROM INFORMATION_SCHEMA.FILES
WHERE FILE_NAME LIKE '%undo%' ;
-- 监控 Purge 滞后情况(MariaDB或Percona Server)
SELECT
    'Innodb_history_list_length' AS metric,
    VARIABLE_VALUE AS value
FROM performance_schema.global_status
WHERE VARIABLE_NAME = 'Innodb_history_list_length'
UNION ALL
SELECT
    'Innodb_purge_lag',
    VARIABLE_VALUE
FROM performance_schema.global_status
WHERE VARIABLE_NAME = 'Innodb_purge_lag'
UNION ALL
SELECT
    'Long Transactions (>300s)',
    COUNT(*)
FROM information_schema.INNODB_TRX
WHERE TIME_TO_SEC(TIMEDIFF(NOW(), trx_started)) > 300;
5.3.3 运维建议
- 避免长事务:设置事务超时时间
- 定期监控:关注 Undo Log 使用情况
- 合理设计索引:减少全表扫描和锁竞争
- 批量操作优化:大事务拆分为小事务
- 版本链清理:定期检查并优化表结构
6. 总 结
6.1 核心结论
- MySQL MVCC 实现:基于 Undo Log + Read View + 版本链,设计精巧
- 对比 Oracle:不会产生 ORA-01555,得益于不同的 Undo 管理机制
- 对比 PostgreSQL:不会产生严重数据膨胀,得益于分离的 Undo 存储
- Undo 空间管理:有明确的配置上限,不会无限制增长,但需要合理配置和监控
- 性能影响:Undo 增长主要通过系统资源竞争影响性能,不同于 PostgreSQL 的直接存储膨胀
6.2 技术选型建议
- 高并发读场景:MySQL MVCC 表现优异
- 长事务处理:注意监控和优化,避免锁问题
- 存储敏感场景:MySQL 空间利用率更高
- 维护成本:MySQL 自动管理,PostgreSQL 需要更多手动维护
- Undo 空间规划:根据业务特点合理配置 Undo 表空间大小和数量
- 性能监控:特别关注 Undo 空间使用率和 Purge 滞后指标
参考资料:
1.MySQL 官方文档 - InnoDB Multi-Versioning
2.《高性能 MySQL》- MVCC 实现原理
墨天轮从乐知乐享的数据库技术社区出发,经过持续积累与升级,已经能够提供多类型数据库管理服务。墨天轮数据库管理服务的目标很明确:一方面,为用户打造一个值得信赖、可以托付的数据库环境;另一方面,也为数据库厂商提供中立、开放的生态支持。
墨天轮数据库服务官网:https://www.modb.pro/service
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。