

浪潮推出高密度AI推理服务器CS5868H3,8U空间集成16张加速卡,算力密度高、互联架构灵活。运行DeepSeek671B模型时性能提升近15%,单机替代多机集群,成本降低超20%。专为MoE大模型、多模态推理深度优化,适配金融、政务等行业落地。
浪潮高密度AI服务器上市,树立大模型推理算力新标杆
作者:技术拾光
时间:2026-08-04
浏览:249
文章目录
生成式AI的落地速度比许多人预想的更快。各行各业正加速搭建大模型应用,千亿参数MoE、图文多模态模型的需求呈现井喷式增长。但现实挑战依然突出——传统推理服务器普遍面临单机算力不足、显存受限、推理成本居高不下的困境。大模型部署的瓶颈已从“能否运行”转向“如何更经济、更高效地运行”,这一核心命题正在倒逼基础设施实现实质性突破。
浪潮CS5868H3:高密度AI推理服务器
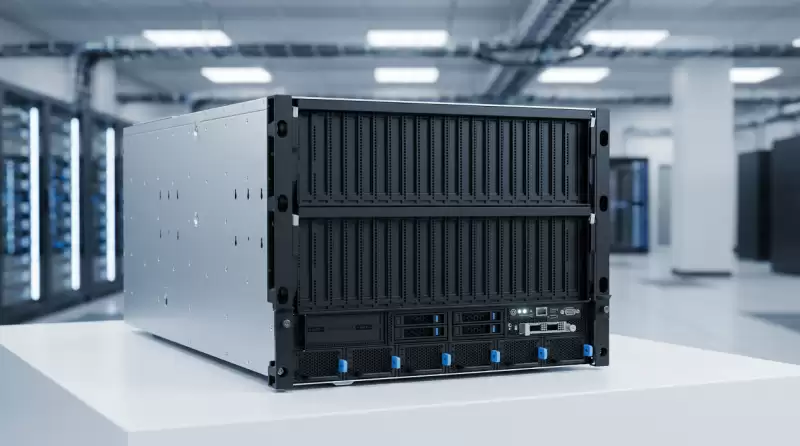
浪潮计算机基于大量行业落地经验,推出新一代高密度AI推理服务器CS5868H3。该机型搭载第四代C86高性能处理器,在8U紧凑空间内集成16张标准PCIe双宽加速卡。核心卖点可概括为“超高算力密度、创新互联架构、全链路高速扩展、高效低耗”,目标直指MoE大模型推理对高显存、高带宽、低延迟的严苛需求,加速金融、通信、政务、能源、科研等行业的大模型推理落地。
灵活互联拓扑与高效布线
节点互联统一采用标准化Cable Tray布线方案,线缆排布整齐规范,便于后期排查与扩容。更关键的是,该服务器可根据实际业务灵活切换Ring环形互联和Mesh全互联两种主流拓扑——不同推理场景对资源调度要求差异较大,灵活切换意味着单台机器即可适应多种场景。实测显示,16卡同步并发数据传输性能优势突出,整机通信时延明显优化,支撑MoE稀疏大模型、图文音视频多模态推理等高交互、高并发算力业务,底气充足。
模块化设计提升运维效率
整机采用四层模块化解耦结构,GPU层、CPU层、供电等硬件单元相互独立,配合抽拉式组件和前维护设计,运维人员可直接在机柜正面完成配件检修与替换,大幅简化工作量。高速信号链路采用无Retimer设计,持续降低信号延迟,增强长期运行稳定性。风道结构经过仿真测算优化,可无缝对接主流机房冷热通道微模块部署方案,契合机房标准化建设要求。
推理性能提升与成本优化
依托全互连架构与超高密度硬件集成,CS5868H3在推理性能提升与整机部署成本管控上实现双向突破。运行DeepSeek 671B大模型推理任务时,相比两台8卡配置的传统PCIe架构服务器,综合性能提升近15%。在模型权重预填充和内容解码两个关键环节,算力输出与显存带宽资源优势明显,业务响应更高效,各类场景可平稳落地。
CS5868H3还针对RAG、Agent、多模态推理进行了深度优化。高CPU-GPU通信带宽解决了向量数据库检索+生成等高交互场景的痛点,完美适配AI推理新范式。成本方面,单机即可替代多机集群,减少机头数量、机柜占用与组网复杂度。相比两台传统4U8卡机型,成本降低超过20%。这不仅是硬件采购费用的节省,机房机柜租赁、配套散热、人力运维等隐性开支也同步下降。大模型落地的门槛与TCO显著降低,为大中小企业推进智能化升级提供实质性利好。
高可靠供电与散热保障
可靠性方面,CS5868H3搭载54V双输入钛金电源,支持N+1冗余与双路供电冗余,供电更稳定、转换效率更高,兼顾节能与安全。即使突发单路电源故障,整机仍可持续工作。通过全链路散热优化与精密气流管理,16卡高负载下也能稳定输出,满足7×24小时不间断推理业务需求。
综合优势与行业展望
综合来看,浪潮CS5868H3在大模型推理领域实现了密度、性能与性价比的全面升级,以8U16卡的硬实力破解超大规模模型推理落地难题。当前国内人工智能产业进入规模化落地关键期,各行各业算力需求持续扩容。浪潮计算机在AI推理基础设施上的持续深耕,以及技术创新与生态开放的推进,值得关注——让高性能算力更普惠、更易用,正是智能化转型的真正方向。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。