

GPT-5将分子克隆方案效率提升79倍,但机器人执行时菌落数量较低,因自然语言指令无法被自动化设备准确解析。BPL(生物协议语言)提供形式化表达体系,通过编译器验证与闭环校正,在300篇NatrueProtocols测试中达95.1%保真度,实现实验意图与执行平台的解耦。
生物学迎来EDA时刻
作者:技术拾光
时间:2026-08-04
浏览:184
文章目录
2025年底,OpenAI联合多家实验室发了一份湿实验室报告。结论很炸:GPT-5通过多轮迭代,自主优化了一个分子克隆方案,效率直接提升了79倍。它不仅提出了一个此前从未被报道过的酶组合——RecA重组酶与噬菌体T4的gp32蛋白协同作用,而且让DNA末端配对效率大幅跃升。
不过,报告里有个细节,被很多人忽略了。
研究团队把方案交给机器人系统执行时,机器人产出的菌落绝对数量,比人工执行低了大约10倍。
这不是方案本身的问题:GPT-5的方案经过人工执行验证,结果完全成立。问题出在“翻译”这一步——如何把大语言模型输出的自然语言方案,准确转化为机器可以确定性执行的指令?
几乎是同一时间,Ginkgo Bioworks宣布旗下三大研发服务业务向自主实验室基础设施迁移,Lila Sciences拿着5.5亿美元融资高调入场,黄仁勋在CES 2026宣告物理AI的“ChatGPT时刻”已经到来。整个行业都在冲向同一堵墙:AI的推理能力已经遥遥领先,但它与物理执行层之间,缺少一座可靠的桥。
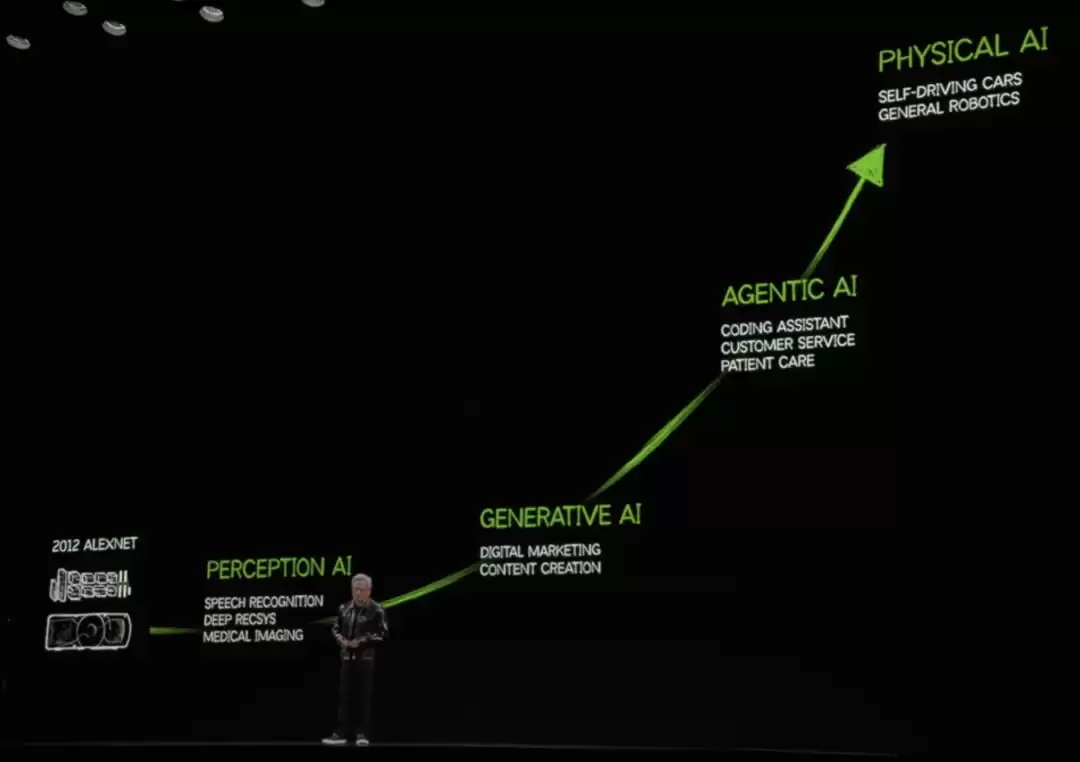
在这场AI对生物世界的进击里,被忽视最久的瓶颈,其实不是算法,不是数据,而是语言。
一个被忽视了几十年的基础设施缺口
生物学是个挺奇特的领域。它拥有世界上最复杂的研究对象,却在用最原始的方式记录和传递知识。
一项发表于Nature、针对1576名科学家的调查显示,超过75%的生物学研究者无法重现他人的实验结果,超过60%的生物学研究者甚至无法重现自己此前的实验。这组数字长期以来被归因于实验操作的复杂性或生物系统的随机性。但说穿了,深层原因其实朴素得多:信息在传递时就已有损失。
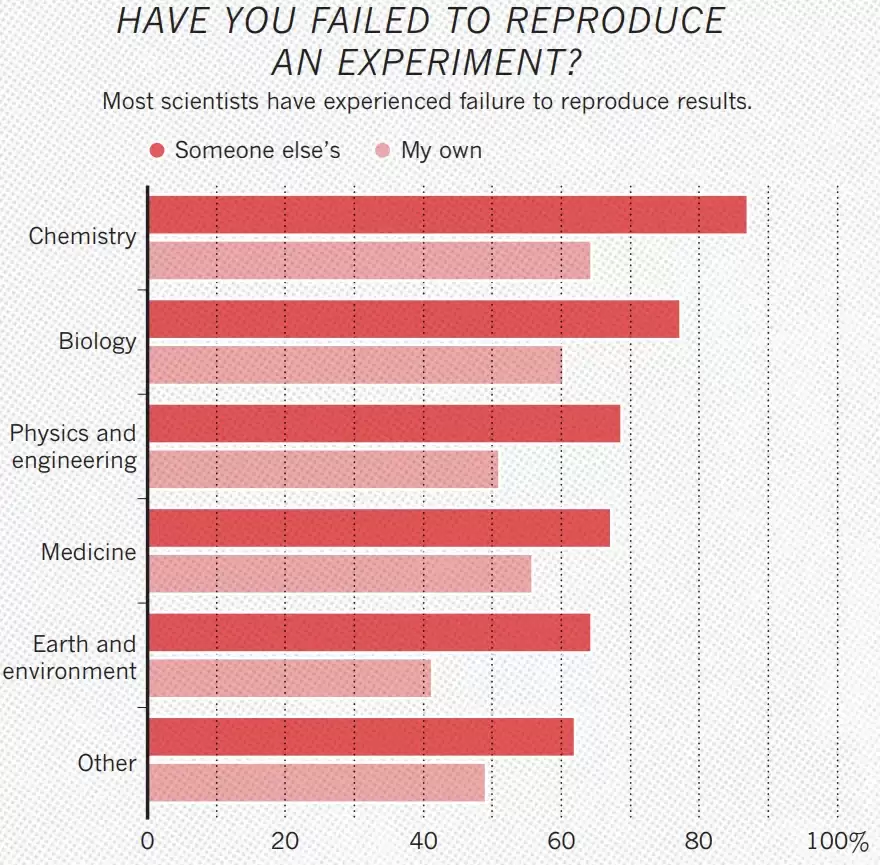
图源:Is There a Reproducibility Crisis Insights from Nature Survey 2016
说到底,原因很直接:生物学实验至今仍主要依赖自然语言描述,而自然语言天生就是模糊的。
举个例子吧,即使是发表在顶刊的论文,你也常能读到类似这样的描述:“将细胞沉淀重悬于冰冷的CaCl溶液中,冰上孵育,然后取适量铺板于选择性培养基上。”
一段时间、轻轻混匀、冰冷的、适量……这些在实验室里习以为常的表达,对另一个研究者而言,却可能对应着完全不同的操作条件。
那些真正决定实验成败的细节,往往并不存在于论文正文,而是存在于实验员的经验、习惯,甚至手感里。
这些难以量化的环节,每一个都是下一次重复实验时可能失败的地方。这些隐含信息存在于原作者的大脑里,存在于实验室的口口相传中,但就是没有被标准化。
相比之下,半导体行业早在几十年前就完美解决了这个问题。芯片设计师用Verilog或VHDL写下精确的硬件描述语言,这段代码可以被编译器解析、形式化验证,再在不同的晶圆厂复现出完全一致的芯片。软件工程用形式化编程语言和确定性构建系统,保证了代码在不同机器上可以精准重现。
生物学缺少的,正是这样一种等价物。
恩和科技AI与Computation总监Alex在接受采访时,打了个很形象的比方:“你可以把整个底层想成是一个CPU,它能够完成实验,但在上面需要有一层编译型的语言——我先去跑一次,看它行不行,行了我再下放到方阵里面执行。”他接着说,“我们先做的是生物铸造厂,后来想让AI去驱动整个铸造厂时,在中间遇到了一个痛点:如果语言模型生成Protocol,生成10次、100次都不一样,我怎么能确定这些自然语言能够在生物实验室里标准化执行?”
这个问题,催生了一门新的语言。
BPL:给生物实验发明一门标准语言
2026年5月,恩和科技在bioRxiv上发布了论文,正式介绍了BPL(Biology Protocol Language,生物协议语言)及其配套管线BPL-COGEN。
- 论文标题:Towards Autonomous Biology: Compiler-Verified Protocols as a Foundation for Real-World AI Execution
- 论文地址:https://www.biorxiv.org/content/10.64898/2026.05.05.720956v1
如果把生物学实验比作软件工程,那么目前行业的状态,大概相当于所有程序员都在用自然语言描述代码逻辑,然后期待另一个人能看懂并手动执行。BPL要做的,就是为生物实验提供一套等价于编程语言的形式化表达体系。
BPL的架构分为六层,层层递进,每一层都在消除自然语言固有的某类模糊性。
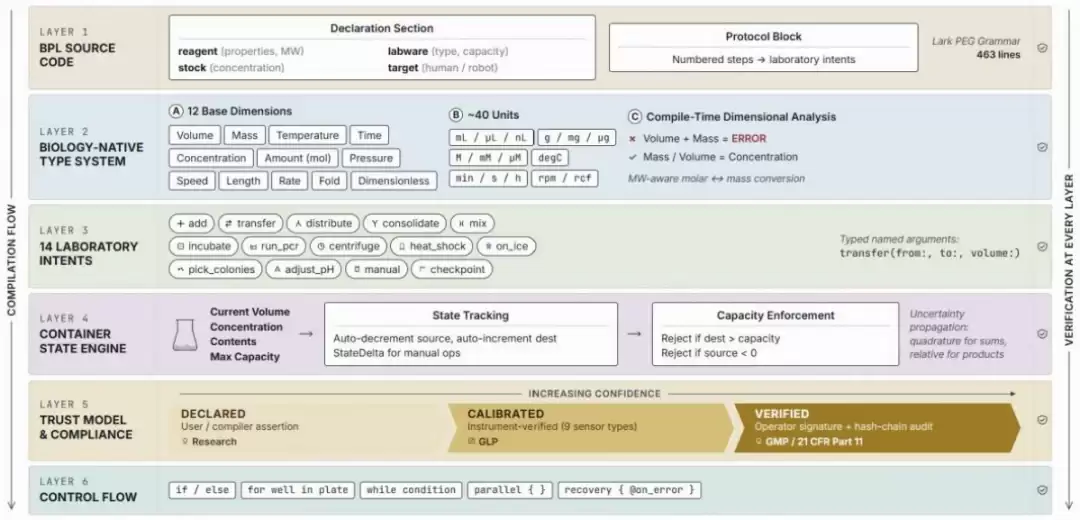
BPL架构图
声明层(Layer 1)是程序的材料清单。所有试剂、库存浓度、耗材类型、执行目标(人工操作还是机器人),在这里都必须以精确的物理属性声明。这样一来,就不再会有“适量CaCl”这种模糊描述了,你必须写明:是固体还是溶液,浓度是多少,用哪种容器。
生物原生类型系统(Layer 2)是BPL最具独创性的设计。它覆盖9个物理基础维度(体积、质量、温度、时间、浓度、物质的量、压力、速度、长度),支持约40种实验室常用单位,并在编译时进行量纲分析。
这意味着什么?如果有人写了“向容器中转移50 mg液体”,也就是把质量单位给了体积参数,编译器会直接报错。所有物理常识都能被形式化为语言级别的约束,让这些错误在编译阶段就被拦截下来。
这层设计直接呼应了那个典型失败案例:OpenAI与Ginkgo合作的实验报告中,GPT-5曾在细胞无蛋白合成实验里建议将水的用量设为负值。这是一个物理上不可能的操作。对于这类错误,Alex直接回应说:“BPL就是干这个事的。这种问题会被卡掉,会被打回来。”
14种实验意图(Layer 3)是BPL与实验室操作之间的桥梁。恩和科技系统分析了150篇发表于Nature Protocols、JoVE和机构SOP库的协议,识别出覆盖分子生物学、生物化学、分析化学95%以上操作的14个原子操作单元:transfer(转移)、mix(混合)、incubate(孵育)、run_pcr(PCR扩增)、centrifuge(离心)、pick_colonies(挑菌)……其中有一个值得单独说明的意图,是manual,即保留人工操作的接口。
Alex解释了这个设计的工程考量:“我们考虑到human in the loop的情况会发生。我已经有自动化仪器可以完成许多任务,但人类或未来的灵巧手在中间可能也会做一些validation等事情——这些事情就可以变成manual。”这是一种务实的工程妥协:某些步骤本质上无法被完全形式化,但manual意图的存在,让它们依然在BPL的管理框架之内。
容器状态引擎(Layer 4)实时追踪程序运行过程中每一个容器的状态(当前体积、内容物组成、温度、物理形态),并在每次操作后自动更新。这个设计来自恩和科技自身多年积累的工程实践。Alex说:“我们以前Cell2Cloud铸造厂每一个96孔板,每一个well都有它的status,它现在到底是在什么样的状态——加了多少,减了多少,状态全部都有。这些东西需要判断,所以它最后就形成了BPL底层的entities。这些不是理论设计,是从我们真实代码库里面抽象出来的,而且它是好用的。”
信任模型与合规层(Layer 5)定义了一个三级信任体系:Declared(用户声明值)、Calibrated(仪器校准值)、Verified(操作员签名+哈希链审计)。GLP、GMP和21 CFR Part 11的合规注解是BPL的原生语言特性,而不是附加的文档要求。
控制流(Layer 6)支持条件分支、循环迭代、并行执行块和结构化错误恢复,让BPL能够处理非线性的、响应式的实验工作流。
在架构图之外,还有一个贯穿始终的能力:意图降低层将高层操作编译为平台特定的执行原语。同一份BPL源代码,可以输出给人类操作员的逐步操作指南,也可以直接生成机器人液体处理工作站的指令文件,还可以进入仿真后端验证——源代码不需要任何修改。这就是“硬件无关的可移植性”在工程上的真正实现:协议意图与执行平台彻底解耦。
值得注意的是,BPL语法经过了14次大版本迭代,以150篇公开发表的协议为验证语料库,并积累了1175个测试用例。可以说,BPL是从真实的实验室场景中迭代打磨出来的。
BPL-COGEN:LLM × 编译器,实现闭环自校正
BPL解决的问题是“协议应该长什么样”,但下一个问题来得更现实:让科学家从头学一门编程语言,并不现实。
所以恩和科技构建了BPL-COGEN:一条将自然语言实验方案自动转译为BPL代码的管线。它的核心机制是一个“生成—验证—修复”的闭环。
BPL-COGEN的架构由一个经过专门微调的30B参数语言模型BPL-Nano-30B(基于Nemotron架构,以2714条精选数据微调而成)和一个确定性编译器联合驱动。二者构成了一个持续迭代的反馈系统。
整个管线分五个阶段运行。
首先是输入归一化:原始SOP文档输入后,系统自动提取结构,并通过双语别名匹配将文档中的试剂和设备名称与本地库存对应,确保生成的声明对应实际可用的物理资源。
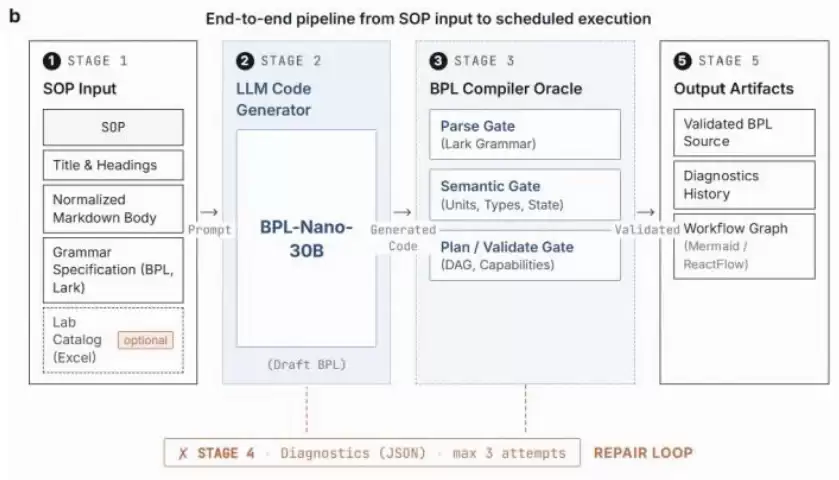
然后是代码生成:归一化文档、完整的BPL语法规范(463行Lark PEG表示法)、章节结构和资源目录,共同构成发给BPL-Nano-30B的提示词。语法规范是逐字包含的,而不是摘要——因为研究发现,对语法做任何形式的压缩,都会显著降低模型首次生成时的语法合规率。
接下来,核心来到三关编译器验证:每个候选BPL程序都必须依次通过解析关(验证语法合规性)、语义关(检查单位一致性、类型安全性、状态连贯性)、规划/验证关(将高层意图降低为有向无环图形式的执行原语,验证依赖关系和硬件能力兼容性)。
这三关的背后,是一套六级编译流水线构成的BPL编译器架构。
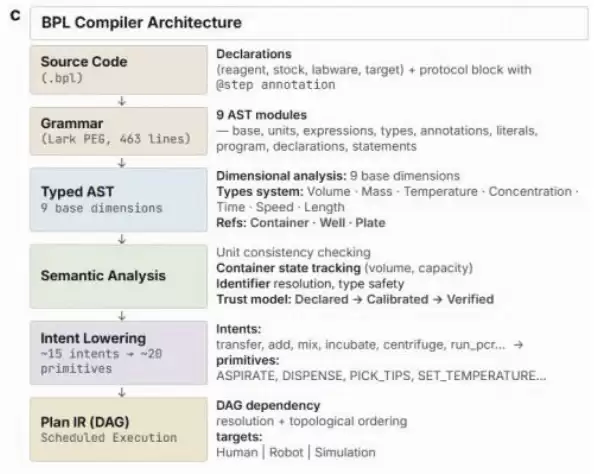
具体来说,源代码首先会经过Lark PEG语法解析,生成带类型信息的抽象语法树(AST);随后进入量纲分析模块,在9个物理基础维度上完成单位一致性检查;语义分析阶段则负责标识符解析、容器状态追踪,以及Declared→Calibrated→Verified的信任级别推进;意图降低层则能将约15种高层实验意图编译为约20种执行原语;最终由调度引擎生成DAG(有向无环图)执行计划,并根据目标平台(人工操作、机器人、仿真)分别输出对应的执行指令。整套编译器由9个AST模块构成,以1175个测试用例保障各层的独立可测试性。这种分层架构意味着:每一类错误都会在最早能够被发现的层级被捕获,并给出精确的诊断定位。
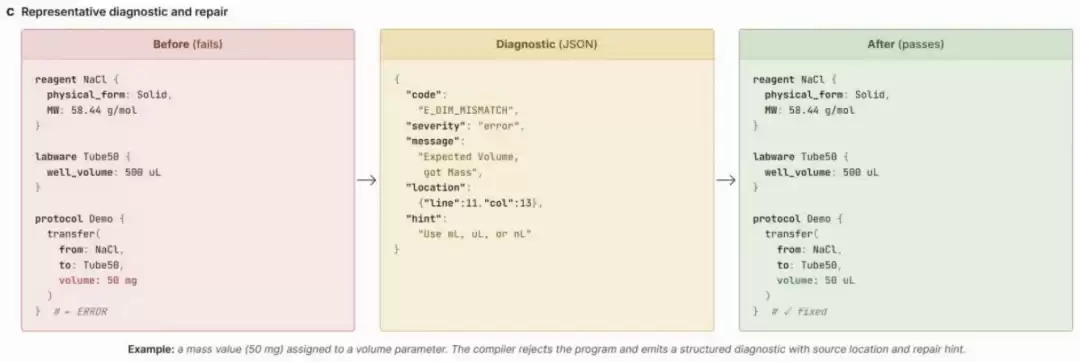
任何一关失败,编译器就会输出一个结构化JSON诊断,其中包含错误码、严重等级、源码位置(精确到行号和列号),以及针对性的修复建议。这个诊断作为上下文化的修复提示返回给语言模型,最多循环3次,形成诊断驱动修复循环。
这是这套架构最重要的设计选择。Alex做了个类比:“它就有点像Cursor一样,自己去跑,跑完了如果不行,就报错,返回来让模型再重新生成,如果可以,就进到实验室。”
这样一来,正确性的保障就从单一语言模型转移到了模型与编译器的协同系统。LLM负责语义理解和代码生成,编译器负责确定性的物理验证,两者各司其职,形成互补。
最终通过所有验证的程序会输出五类确定性产物:版本可控的BPL源码、含有依赖关系的DAG执行计划、体积追踪和单位转换审计报告、工作流可视化图、以及逐步容器状态追踪记录。
有效性得到验证
编译器能发现什么?在一批基准样本中,编译器共发出了343条诊断,分布于五类错误。
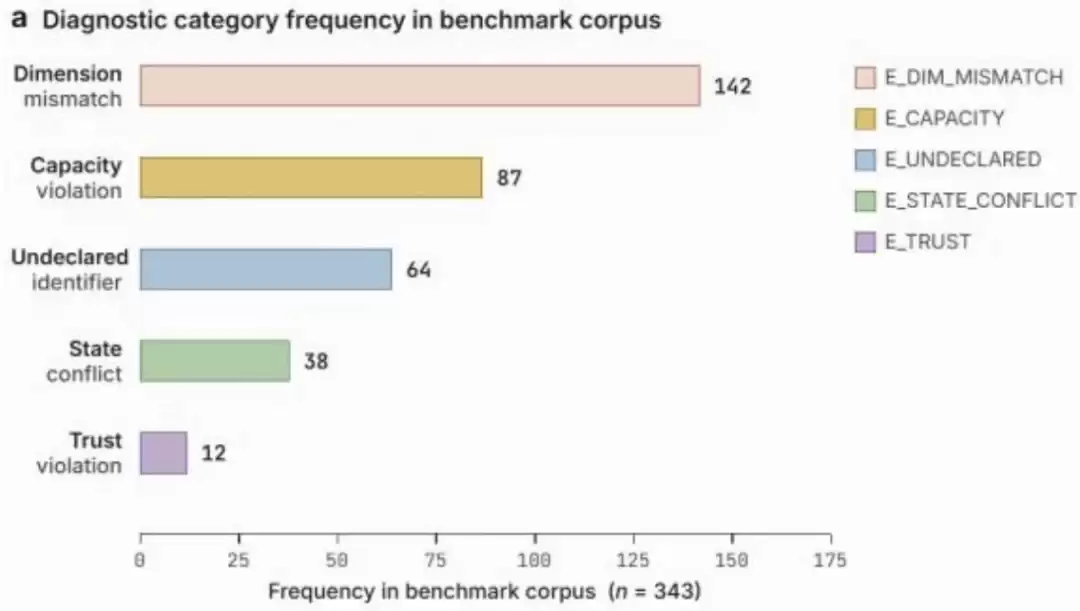
最常见的是量纲不匹配(142次,41.4%)。论文中展示了一个示例:transfer(from: NaCl, to: Tube50, volume: 50 mg),也就是把质量值给了体积参数。编译器精确定位到第11行第13列,提示“请使用mL、uL或nL”,语言模型将其改为volume: 50 uL,通过。
另外还有容器容量违规(87次)、未声明标识符(64次)、状态冲突(38次)以及信任违规(12次)。
这五类错误,在自然语言SOP中都是隐形的,通常只能靠实验失败后事后再来定位。
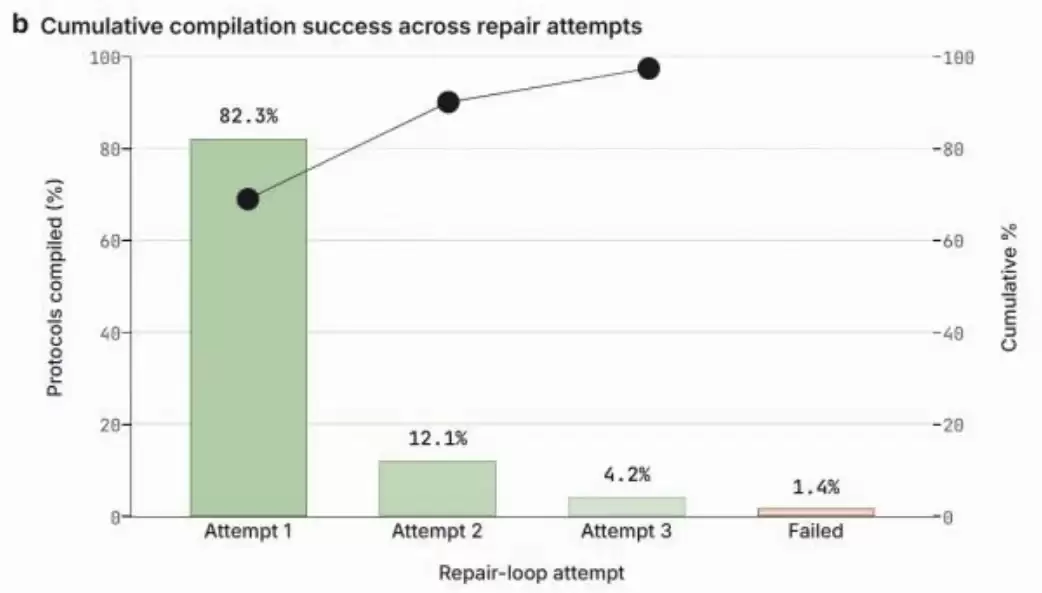
修复闭环的效率也很具体:82.3%的协议在首次尝试就编译通过;需要修复的变体中,12.1%在第一轮诊断后通过,4.2%在第二轮后通过,累计98.6%在两轮迭代内解决。仅有1.4%无法自动修复——通常是源SOP本身存在根本性矛盾或深度歧义,必须人工介入。
数字之外,更有力的证明是物理层面的验证。
案例一:GFP表达质粒文库构建。团队构建了11个GFP荧光蛋白表达质粒。BPL-COGEN从同一份BPL源程序编译输出两套协议:一套给人类操作员的逐步操作指南,一套给Biomek i7液体处理工作站的机器指令文件。源代码不做任何修改。
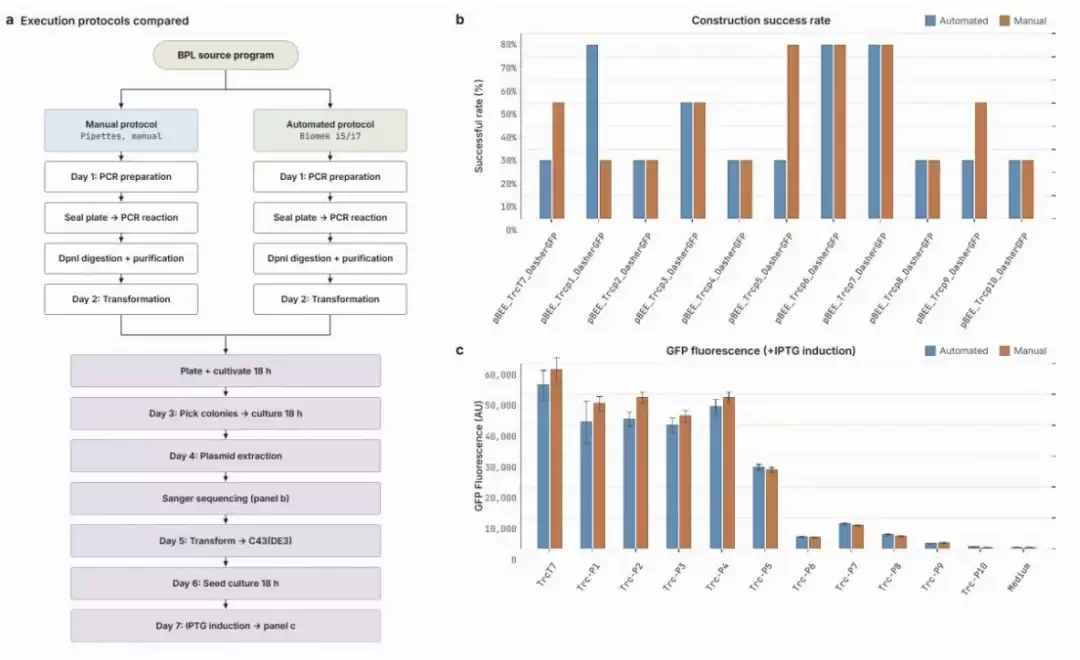
结果:PCR扩增、Gibson Assembly组装、细菌转化、Sanger测序验证,人工组和机器人组的构建成功率高度相近。将质粒转入大肠杆菌后,11个菌株在IPTG诱导下显示出清晰的荧光梯度,且这个梯度在两套样品中高度一致。
其工程意义不在于实验成功,而在于同一份源码,在两种执行模式下产出了可比较的结果。“协议意图与执行平台解耦”有了真实的物理佐证。
案例二:HPLC到UHPLC方法迁移。原方法使用传统C18柱,对5种脂溶性化合物(视黄醇、视黄醛、视黄酯、番茄红素、β-胡萝卜素)进行分析,单次运行时间32分钟。BPL-COGEN自动调用2025版《中国药典》0512章节的柱转换公式,计算出迁移后的方法参数,执行后单次运行时间压缩到2.1分钟,溶剂消耗减少95.8%,5种化合物全部实现基线分离。
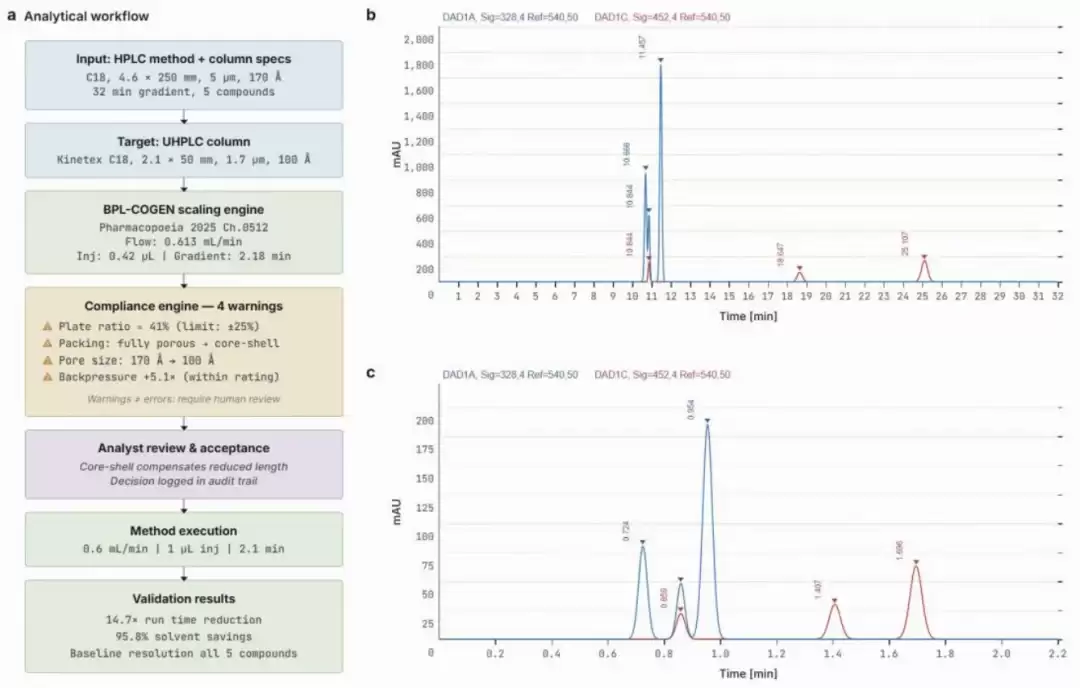
值得注意的是,这个过程中BPL合规引擎发出了4条警告:标记出超出药典等效阈值的偏差,包括理论板数减少41%(超过25%等效限)、填料类型从全多孔改为核壳等。分析员审阅了全部4条警告,评估后做出接受决定,这一判断也被自动记录进审计追踪。这正是合规的正确实现方式:在执行前完成结构化的判断与记录,而不是事后贴一份签名文件。
在300篇Nature Protocols论文的规模化基准测试中(其中每篇文章都使用Claude Opus 4.6、GPT-5.3-codex和Gemini-3-pro-preview各生成多个独立变体,共2992个有效变体),BPL-COGEN总体保真度得分达到95.1±8.3。
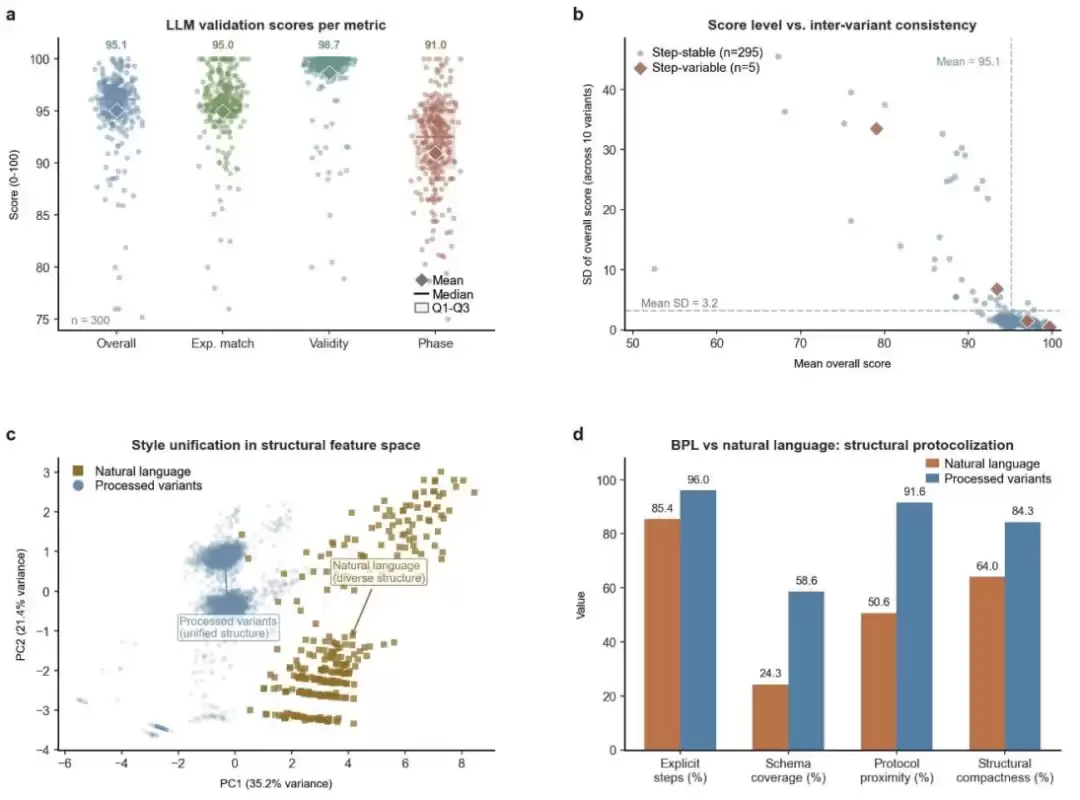
更值得注意的是结构一致性:295/300篇论文,在10次独立生成中保持步骤结构完全稳定。那些原本“弥散分布在特征空间中”的不同风格实验文档,经过BPL处理后,收敛到了一个紧密的“类协议流形”——不管输入的原文风格有多不同,输出都趋向同一种结构化表示。
BPL之上:SAION AI如何让实验室自己跑起来
BPL解决的是协议层的问题。但在整个Physical AI的架构里,它是执行层的基础设施,而不是终点。
恩和科技在BPL之上构建的是SAION AI,这是一个覆盖认知、编排、执行全链路的生物制造Physical AI平台,于2026年3月正式发布。
恩和科技AI产品负责人李政远(Red)在接受采访时说:“我们做AI的初衷,是让AI接管我们做实验到完成科研课题的全过程。科研的核心要素就三件事:搜信息、做决定、做校验。AI在前两件事上已经做得很不错了。我们阶段二要做的是让AI提供的东西不只停留在虚拟世界,而是能够进入真实湿实验室,进入物理世界,做真正的校验。”
SAION AI的架构分三层,与自动驾驶的“感知—决策—执行”高度同构,恩和科技称之为“认知—控制—执行(COE)”。
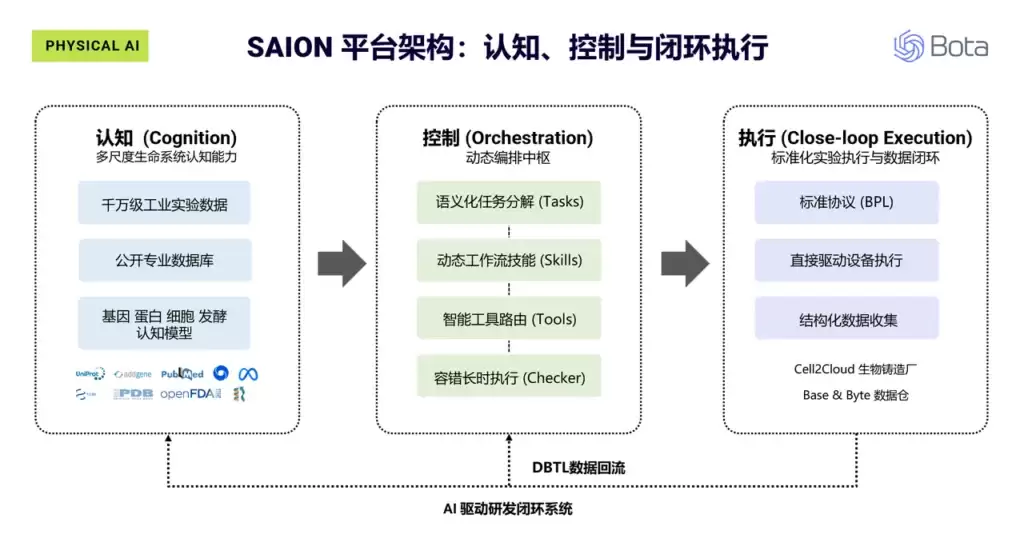
认知层是系统的知识基础。它整合了恩和科技Cell2Cloud生物铸造厂六年积累的千万级闭环实验数据以及百万级文献与专利,同时接入AlphaFold、ProteinMPNN、RFDiffusion、ESMFold等前沿AI4Science模型,覆盖蛋白结构预测、序列生成、代谢通路分析、酶工程和发酵数据建模,实现从基因到蛋白到代谢到细胞到发酵的多尺度认知。
这“千万级闭环实验数据”意味着什么?Alex给出了一个具体的描述:“我们的数据库primary key是一个菌株ID,从它出生,从电脑里面设计开始,一直track到最后发酵甚至生产结束。每一个module都会产生很多数据,比如这个菌株是怎么设计的、DNA序列是什么、CRISPR的编辑方式、转化用了什么host、培养到分析、发酵过程中的PH、温度、溶氧……单一个发酵罐就有21万个数据点,从头到尾拉下来叫一个闭环。”
这套数据已积累多年,也是恩和相对于纯计算路线的AI4S公司最重要的差异化资产。
控制层是系统的决策中枢,核心是Agent Harness智能体编排引擎。它以LLM推理为核心,将复杂科研目标拆解为结构化任务图,协调316种专业科研工具的动态调用,涵盖各类生物信息学计算工具、蛋白质预测模型(包括diffusion model)、序列比对、DNA设计、primer设计等。系统内置Checkpoint存档和容错机制,支持长周期复杂科研流程的稳定运行。
Red举了个例子:“同一个问题,我让SAION AI和千问Max同时回答:如何用合成生物学方法以低于200美元每公斤的生产成本生产尿石素?SAION AI的信息来自论文和专利,推理更深更全面,计划明确,可执行性更高。这在两年前,我们已经做到了这个程度。”
执行层是BPL的主场。SAION AI生成的实验方案,通过BPL转化为标准化指令,驱动移液工作站、培养与检测设备执行。实验数据实时回传并结构化入库,形成Design-Build-Test-Learn(DBTL)的真正闭环。
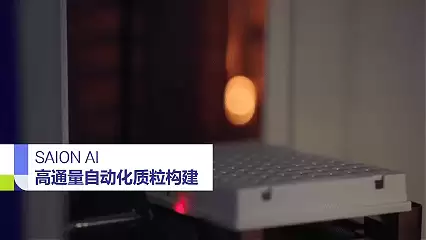
这套闭环不只是架构图上的箭头,它已经在真实产业项目中跑通。恩和科技自主开发的ZeaVida精准发酵全反式玉米黄质,就是迄今最具说服力的一个案例:这个项目刚刚获批美国FDA GRAS认证。这是全球首个通过细胞工厂实现规模化生产的玉米黄质高浓度晶体产品获得该认证。
在性能基准上,SAION AI在科研文献理解(LitQA+SuppQA)上达到70.7%平均准确率,在生物序列分析与设计基准Seq QA上以88.2%超过斯坦福发布的Biomni平台(81.9%),在基因编辑与克隆场景上以84.9%的成绩获得显著优势,在科学发现与推理基准BAIS-SD上达到89.6%。在四个主要基准上均以10至20个百分点的幅度领先GPT-5.3、Claude Opus 4.6等通用旗舰模型。
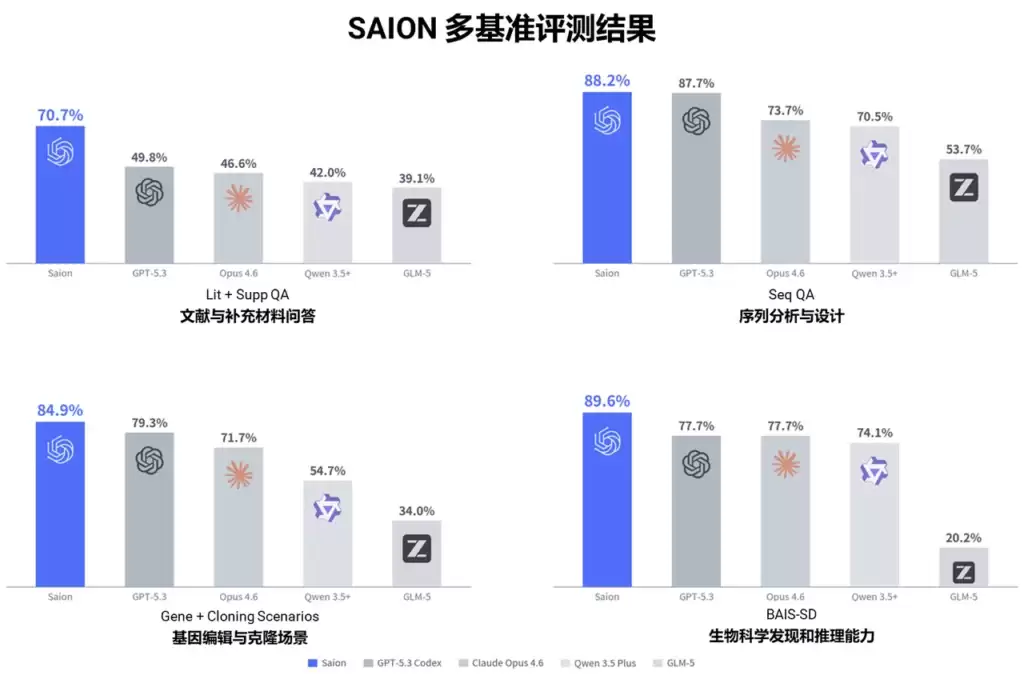
Red也强调了评估方式的特殊性:“如果你要让科学家相信你,要求很高,因为科学家容错率很低。我们的评测是:科学家用了,放到实验室里跑,跑出来结果挺好,那这就是我们完整的评测。我们不只跑benchmark,更重要的是,我们有20多个项目在跑,每天能产生几万的菌株参数,这些都是AI产出的设计落到实验室里做出来的结果——这种规模的内部评估,也在持续进行。”
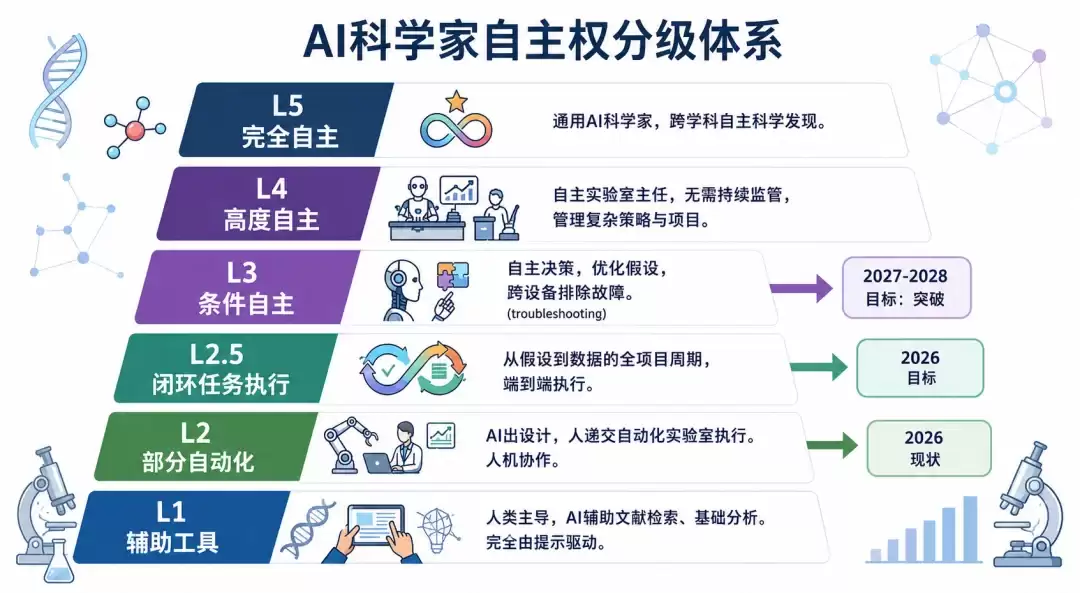
在整个系统闭环的层面,Red用了一个分级模型描述了现阶段的进展:“我们可以用类似自动驾驶的分级模式来衡量AI科学家的自主程度。目前恩和大概处于2级——能够与部分自动化设备集成,让AI出设计,直接递交到自动化实验室执行。我们计划今年达到2.5级,能让AI完全驱动一个完整项目的闭环。明后年的目标是突破3级,实现能够自主做决策、自主troubleshooting的AI科学家。”
生物学的工程化纪元
如果给恩和BPL要做的事情找个参照,可以是半导体行业里的EDA(电子设计自动化)。
EDA出现之前,芯片设计师在纸上手绘逻辑图。EDA出现之后,芯片设计变成了一种可形式化验证的工程活动,并直接催生了Fabless(无晶圆厂)模式——设计与制造彻底分离,ARM、高通、英伟达都不需要自己建晶圆厂。整个行业进入了可编程化、可规模化的工业轨道。
Alex作为半导体出身的“跨界者”,对这个类比有着深刻的感受:“半导体厂叫Foundry,生物制造的核心也叫Biofoundry。两者在逻辑上高度同构:都是将元件组合,产出特定功能的产品。只是生物系统比半导体更难——因为它是活的,它的第一性原理还在探索中,半导体的逻辑底层是人类发明的、清晰的,但生物本身是我们去发现的,内部运动的参数太不确定了。”
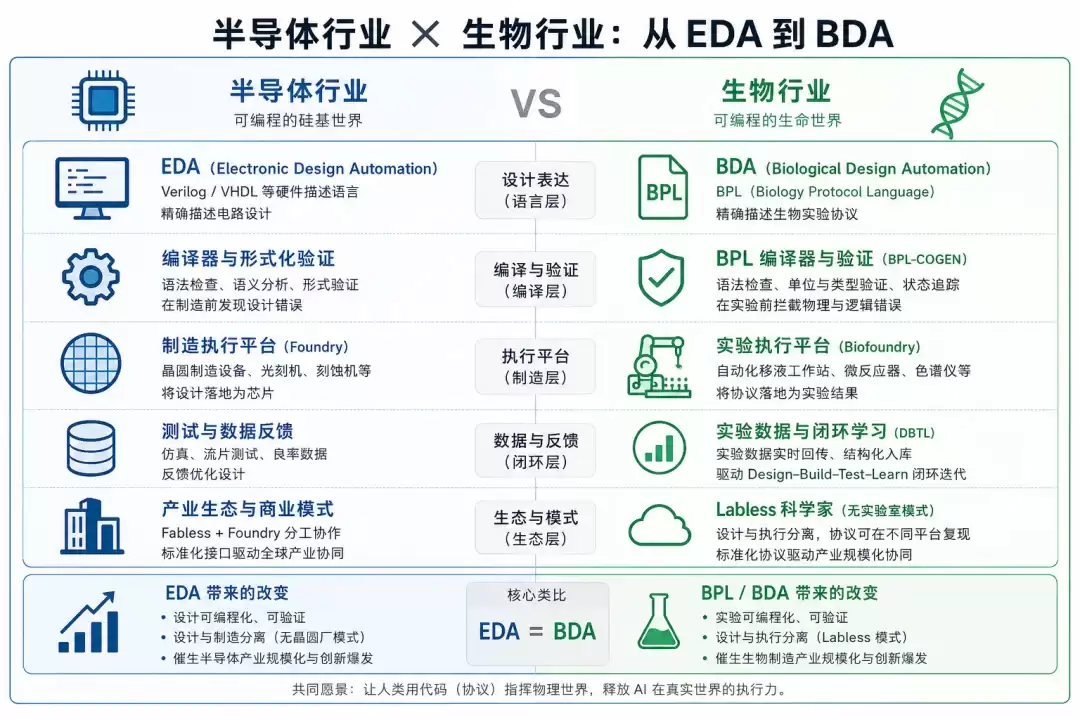
正因为如此,BPL要做的事情才格外重要:在一个底层规律本身还不完全清晰的领域,提供一套能把“当前已知”精确表达并执行的语言基础设施。
BPL正在尝试构建的是生命科学领域对应的BDA(Biological Design Automation,生物设计自动化)。它试图解决的问题与EDA高度同构:让生物实验的“设计意图”能够被精确表达、形式化验证,然后在不同的“制造”环境中忠实复现。
EDA催生了无晶圆厂模式,而BPL可能催生的是Alex称之为“Labless”的模式——实验设计与物理执行的深度分离。Alex说:“就相当于我今天在用大模型跑沙盒;我现在要去做实验,我在一个沙盒里先把BPL跑一次,看它能不能在仿真实验里成功,如果成功了,我再丢去真实实验室。它是AI进入生物物理世界非常重要的基石,类似于半导体的EDA和写代码的编译层。写代码的人肯定知道这层很重要;而生物的人,也在慢慢意识到这层有多重要。”
关于BPL能走多远,Alex的判断是:“BPL未来开源之后,会有更多的反馈,覆盖的面会更广。它是一个面向整个行业的协议,像HTTP和MQTT这样的协议。它的左边是AI,右边是真实实验——物理层面的实验。”
生命科学正在经历一场深刻的结构性演进:从一门依赖偶然发现与经验试错的探索性学科,稳步迈入可计算、可预测的工程性纪元。
当一门科学真正演变成为工业化的工程体系,它必然呼唤属于工程本身的底层基建:标准化的表达语言、可验证的执行流程以及精确可量化的质量控制。
BPL是这套工程基础设施的语言层。每一个实验步骤都能精确表达、编译验证,每一次执行失败都能定位到具体的指令。
正如本文开篇所言,GPT-5在分子克隆实验里设计出了效率提升79倍的方案,但那10倍的执行差距告诉我们:光有大脑还不够,还需要一套让大脑与双手之间的语言真正标准化的基础设施。
这,正是BPL正在做的事。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。