

Google Cloud可靠性Skill 1.1.0把降级措施、影响衡量与用户体验优先级分开询问,并联系SLO和可观测性;它不替代部署或实时故障排查。
Google Cloud可靠性Skill 1.1.0怎样评估降级对用户体验的影响?
作者:资源驿站
时间:2026-11-14
浏览:527
文章目录
Google Cloud可靠性Skill 1.1.0评估优雅降级时,除了询问高负载或部分故障下采取什么措施,还要求了解降级对用户体验的影响如何衡量、怎样缓解,以及降级期间如何安排体验优先级。讨论重点由“有没有降级机制”进一步延伸到“关键用户体验是否仍被保留”。
有降级能力,不等于知道降级影响
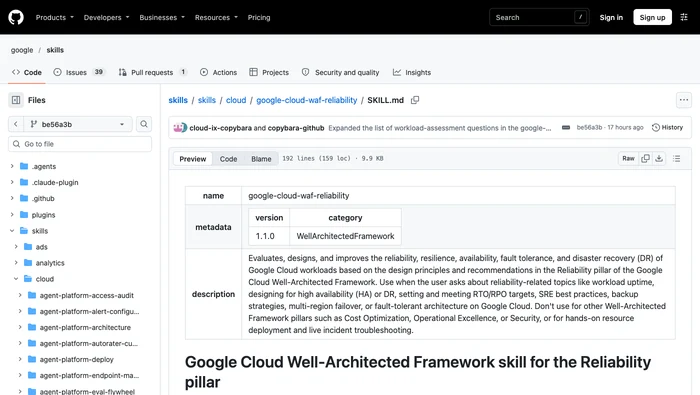
可靠性Skill依据Google Cloud Well-Architected Framework的可靠性支柱提供架构评估知识。它把可靠性放在用户体验目标下理解,而不是仅依赖基础设施指标。因此,即使系统仍有实例运行,也需要分清哪些用户功能可用、哪些体验受到影响。
1.1.0的问题清单在优雅降级原则下询问三类内容:高负载或部分故障时采取什么措施;性能下降对用户体验的影响怎样衡量并缓解;降级期间优先保障哪些用户体验。这些问题需要业务目标与运行实践的上下文,不能只列出一种技术模式就视为已经答完。
技术模式与发现问题处于不同层面
Skill的核心原则部分列出熔断、有效处理超时、带指数退避和抖动的重试,以及自定义错误响应或静态回退页面等建议。这些模式旨在释放被阻塞资源、避免级联故障,或保留关键功能;它们没有提供一套适用于所有应用的统一参数。
例如,是否已有重试机制,与重试会不会给正在恢复的后端造成额外压力,是不同的问题。是否存在回退页面,与它是否保留用户最需要的信息,也不是同一件事。该Skill适合围绕架构约束进行评估,不应从某个模式的名称直接推断线上行为已经符合目标。
降级评估为什么仍要联系SLO与可观测性?
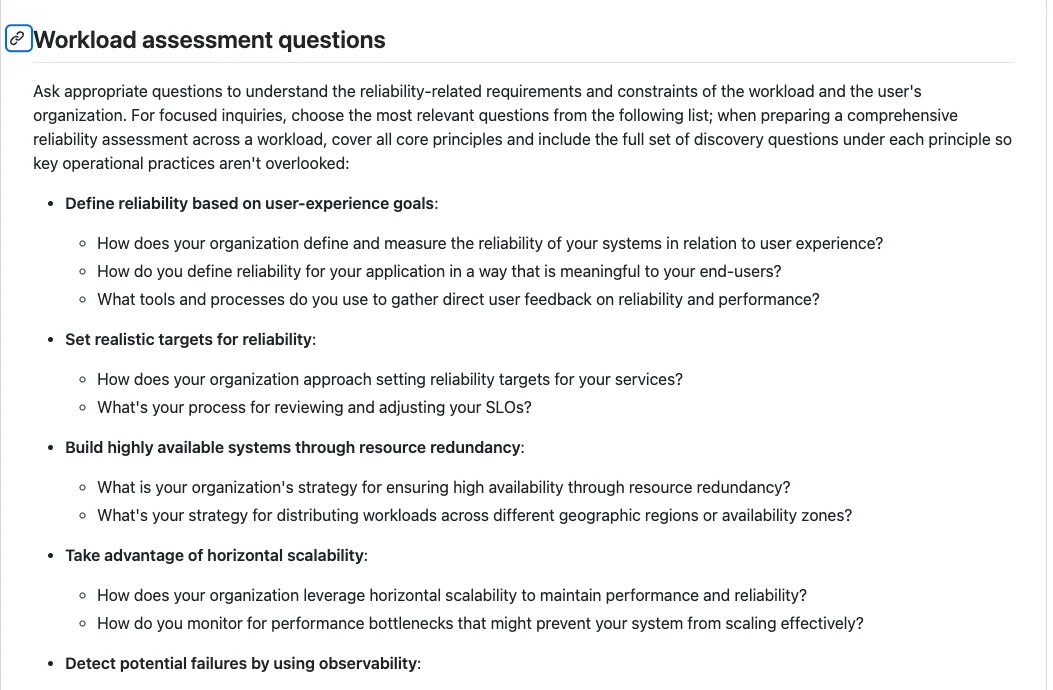
SLO用于把可靠性目标与业务需要联系起来。1.1.0不仅询问组织如何设定目标,也询问复审和调整SLO的流程。可观测性部分则关注指标、日志、链路追踪,以及如何让重要问题得到及时响应,同时避免告警疲劳。
这些问题与降级体验相关:只有明确关注的用户结果和信号,才能讨论性能下降意味着什么,以及哪些变化需要响应。Skill提到延迟、流量、错误和饱和度等黄金信号,但没有因此承诺一个对所有工作负载通用的报警阈值或可用性数值。
专项讨论与全面评估怎样避免混用?
如果任务仅是理解某项降级策略,1.1.0允许选择最相关的问题。若要对整个工作负载进行全面可靠性评估,就必须覆盖所有核心原则及每项原则下的完整问题集,不能用降级章节代替冗余、扩展、恢复测试与复盘等方向。
评估之后得到的是对要求、约束与实践的理解,不是一次自动完成的部署或线上演练。这项Skill明确不用于直接资源部署,也不用于实时事故排查;成本优化、安全等其他框架支柱同样不在它的适用范围内。把讨论范围说清,才能避免把针对降级的局部结论扩大成整套系统已经可靠的证明。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章